PolicyLM-1.7B: modelul AI care moderează conținut în timp real

Timp de citit: 5 minutes

PolicyLM-1.7B este un nou model de inteligență artificială conceput pentru moderarea rapidă a conținutului online, într-un domeniu în care platformele trebuie să analizeze milioane de mesaje, comentarii, username-uri și conversații și să identifice încălcările regulilor fără a bloca în mod eronat conținutul legitim.

Modelul a fost lansat de Musubi, companie specializată în soluții pentru Trust & Safety, și este prezentat ca un model AI de tip „decision model”, conceput pentru situațiile în care deciziile de moderare trebuie luate aproape instantaneu. PolicyLM-1.7B este disponibil cu ponderi open-weight sub licența Apache 2.0 și poate fi utilizat pentru aplicarea unor politici de moderare personalizate.

Ce este PolicyLM-1.7B?

Pe scurt, PolicyLM-1.7B este un model AI care citește politica de moderare a unei platforme și acordă scoruri pentru categoriile definite de regulile respective.

Spre deosebire de un chatbot tradițional, modelul nu generează un răspuns textual pentru fiecare mesaj. În schimb, returnează scoruri între 0 și 1 pentru categoriile de moderare relevante. Această abordare permite reducerea costurilor și a latenței atunci când obiectivul principal nu este generarea de text, ci luarea unei decizii.

Conceptul este important deoarece există o diferență fundamentală între un LLM generalist și un model de decizie AI. Un LLM poate analiza o regulă complexă, poate explica o decizie și poate gestiona cazuri ambigue, însă generarea unui răspuns complet poate fi prea lentă sau costisitoare pentru moderarea fiecărui mesaj dintr-o platformă cu trafic foarte mare.

PolicyLM-1.7B urmărește exact cealaltă extremă: o decizie specializată, rapidă și scalabilă.

De ce este diferit față de sistemele clasice de moderare?

Sistemele tradiționale de clasificare a conținutului sunt de obicei antrenate pentru o taxonomie prestabilită. Dacă o platformă își modifică politica sau introduce o categorie nouă, schimbarea poate necesita date noi, etichetare și, în anumite cazuri, reantrenarea modelului.

Musubi propune un mecanism diferit: politica poate fi transmisă modelului împreună cu mesajul analizat. Astfel, echipa de moderare poate defini propriile categorii de conținut pe care dorește să le identifice, de la hărțuire, amenințări și fraudă până la spam, tranzacții realizate în afara platformei, conținut periculos sau comportament antisocial.

Regulile pot fi formulate în limbaj natural, iar modelul returnează un scor pentru fiecare categorie. Potrivit Musubi, modificarea politicii nu necesită reantrenarea modelului sau reconstruirea unui cache.

Această caracteristică poate fi relevantă în special pentru platformele ale căror reguli se schimbă frecvent.

Cât de rapid este PolicyLM-1.7B?

Unul dintre principalele avantaje declarate de Musubi este viteza. Într-un benchmark realizat de Musubi, analiza unui mesaj scurt în raport cu șase reguli de moderare a avut o latență mediană de aproximativ 35 ms, pe un GPU NVIDIA L4 de 24 GB..

Pentru moderarea în timp real, această diferență contează. Un sistem care analizează mesajele după ce conversația s-a încheiat are o utilitate diferită față de unul care trebuie să decidă dacă un mesaj poate fi afișat înainte ca utilizatorul să-l vadă.

Musubi indică mai multe scenarii în care PolicyLM-1.7B poate fi utilizat pentru moderarea conținutului în timp real, de la chat-uri live și lobby-uri de jocuri până la mesaje directe și username-uri. Modelul poate fi folosit, de asemenea, în cadrul comunităților online și al platformelor care gestionează volume foarte mari de mesaje, unde viteza de procesare și scalabilitatea sunt esențiale.

Compania spune că o versiune personalizată și fine-tuned a PolicyLM rulează deja într-un mediu care procesează peste un milion de mesaje pe zi.

PolicyLM-1.7B vs. LLM: care este diferența?

Un LLM generalist este flexibil, dar această flexibilitate are un cost. Modelul trebuie să interpreteze instrucțiunile, să proceseze contextul și să genereze un răspuns.

PolicyLM-1.7B este construit pentru o sarcină mult mai restrânsă: clasificarea conținutului în funcție de o politică definită de utilizator.

Diferența poate fi rezumată astfel:

CaracteristicăClasificator tradiționalLLM generalistPolicyLM-1.7B
Politică personalizatăLimitatăDaDa
Generează textNuDaNu
Scoruri pentru categoriiDaIndirectDa
Latență redusăDaDe regulă mai dificilDa
Schimbarea politicii fără reantrenareLimitatăDaDa
Open weightsDepinde de soluțieDepinde de modelDa
Potrivit pentru fiecare mesaj în timp realDaPoate fi costisitorDa

Musubi subliniază că modelele mari rămân utile pentru situații care necesită raționament, contestații, suspendări sau decizii complexe. Modelele specializate, în schimb, pot fi utilizate pentru analiza la scară a volumelor mari de conținut.

Ce înseamnă „decision model”?

Termenul decision model descrie o categorie de modele AI orientate către producerea unei decizii sau a unei probabilități, nu către generarea unui răspuns conversațional.

Această abordare a început să câștige teren în 2026, odată cu apariția unor modele capabile să ia decizii precum Jev și a altor soluții dezvoltate de companii din industria AI. În domeniul moderării conținutului, astfel de modele pot transforma regulile unei platforme în decizii automate, rapide și ușor de scalat.

Avantajul este evident pentru un caz de utilizare precum moderarea: dacă platforma are nevoie doar să știe dacă un mesaj depășește un anumit prag, generarea unui răspuns de câteva sute de tokeni nu este necesară.

Cât de precis este modelul?

Musubi afirmă că PolicyLM-1.7B a obținut aproximativ 83% acuratețe în propriul benchmark de politici personalizate și că, în testele companiei, a depășit celelalte modele testate cu mai puțin de 20 de miliarde de parametri. Comparația este prezentată de Musubi și trebuie interpretată în contextul benchmark-ului și metodologiei proprii, nu ca o demonstrație universală că modelul este superior tuturor sistemelor de moderare. Pentru implementări reale, această distincție este esențială.

Musubi oferă două presetări pentru pragurile de detecție: „precision”, orientat către reducerea alarmelor false, și „balanced”, destinat unui compromis diferit între detectarea încălcărilor și falsele semnalări. Compania recomandă calibrarea pragurilor pe un eșantion propriu de conținut înainte de lansarea în producție.
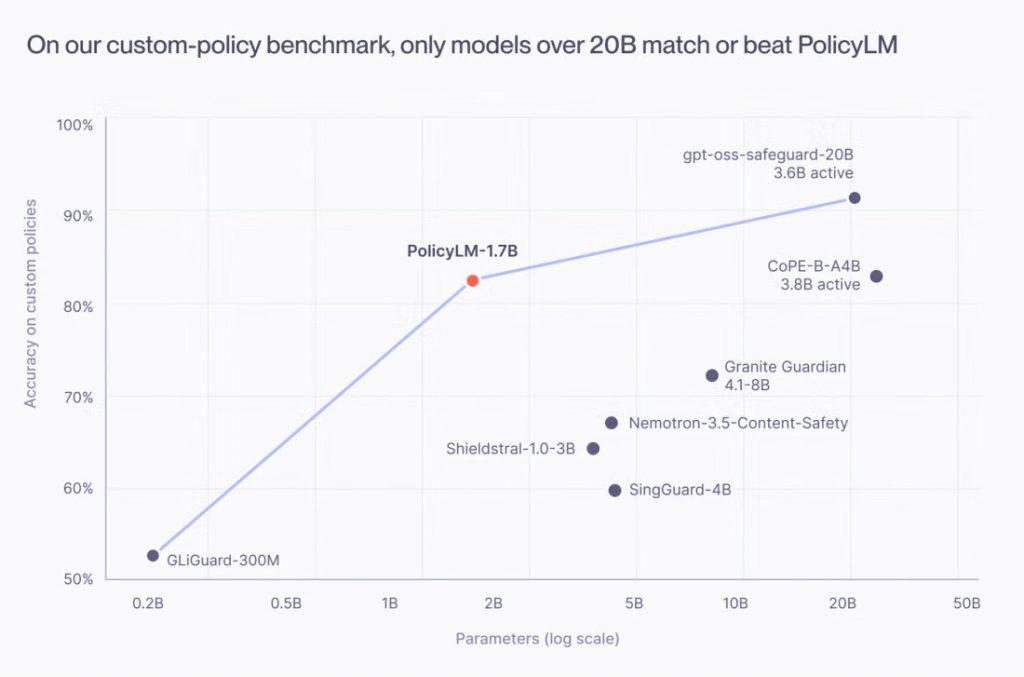
PolicyLM-1.7B testare

Care sunt limitele PolicyLM-1.7B?

PolicyLM-1.7B nu trebuie privit ca un înlocuitor universal pentru moderatori umani sau pentru LLM-uri. Conform documentației Musubi, modelul este text-only, analizează câte un mesaj și nu utilizează istoricul conversației. De asemenea, performanța diferă între cele 19 limbi evaluate, engleza fiind limba cu cele mai bune rezultate, iar tamilul fiind menționat ca cea mai slabă limbă din evaluarea respectivă.

Există și un alt compromis important: modelul returnează scoruri, dar nu oferă explicații textuale pentru decizie. În practică, PolicyLM-1.7B ar putea fi folosit ca prim filtru pentru mesajele care trebuie analizate rapid. Cazurile în care scorul este neclar sau în care este nevoie de o analiză mai complexă pot fi apoi trimise către un model AI mai puternic sau către un moderator uman.

Astfel, modelul specializat se va ocupa de volumul mare de mesaje, iar resursele de analiză mai costisitoare vor fi rezervate situațiilor care necesită o evaluare suplimentară. Această abordare de tip routing sau cascading poate combina viteza modelelor mici cu capacitatea de raționament a modelelor mari.

Ce impact ar putea avea asupra moderării conținutului?

Apariția unor modele precum PolicyLM-1.7B indică o posibilă schimbare de abordare în moderarea conținutului cu ajutorul inteligenței artificiale. Până acum, alegerea era adesea prezentată ca un compromis între clasificatoare rapide, dar rigide și LLM-uri flexibile, dar mai lente și mai scumpe.

Modelele de decizie încearcă să ocupe spațiul dintre cele două. Pentru platforme, implicația strategică este importantă: politica de moderare poate deveni un strat configurabil al sistemului AI, în loc să fie complet „înglobată” în parametrii unui clasificator antrenat pentru o taxonomie fixă.

Astfek, echipele Trust&Safety pot adapta rapid regulile atunci când apar noi tipuri de abuz, fraudă sau modificări ale politicilor comunității.

Concluzie: este PolicyLM-1.7B o alternativă la LLM-uri?

Nu în totalitate. Mai degrabă, PolicyLM-1.7B este o piesă nouă într-o arhitectură de moderare AI. Modelul este interesant deoarece combină trei caracteristici dificil de obținut simultan. Acestea includ politici personalizabile, latență redusă și costuri de rulare apropiate de cele ale unui clasificator.

Faptul că este disponibil cu ponderi open-weight sub Apache 2.0 permite organizațiilor să îl testeze și să îl ruleze pe propria infrastructură, conform condițiilor licenței. Modelul pornește de la BidirLM-1.7B-Embedding, un encoder derivat din Qwen3-1.7B-Base. Pentru antrenament s-au folosit mai multe seturi de date pentru siguranță. Acestea includ Nemotron Safety Guard Dataset v3, XGuard-Train-Open-200K și PolyGuardMix, alături de date sintetice.

Pentru companiile care gestionează comunități online, jocuri, platforme sociale sau servicii cu chat în timp real, întrebarea nu mai este doar „ce model AI poate modera conținutul?”, ci și „ce model ar trebui să ia fiecare tip de decizie?” PolicyLM-1.7B reprezintă una dintre încercările recente de a răspunde la această întrebare printr-un model specializat, rapid și adaptabil la politica proprie a unei platforme.

Sursa: musubilabs.ai

PRODUSE RECOMANDATE

Jev, un model AI diferit de LLM-urile tradiționale

Timp de citit: 5 minutes

Un nou tip de model de inteligență artificială încearcă să schimbe modul în care software-ul folosește AI-ul. Jev, dezvoltat de TypeSafe AI, nu este un Large Language Model (LLM) clasic și nu este conceput pentru conversații. În schimb, modelul produce decizii structurate, însoțite de probabilități și estimări de încredere, cu scopul de a face automatizarea software mai rapidă, mai ieftină și mai predictibilă.

Ideea a atras rapid atenția dezvoltatorilor, iar apariția lui Jev marchează o posibilă schimbare de direcție în dezvoltarea aplicațiilor bazate pe inteligență artificială. Informațiile au fost prezentate de TechCrunch pe 18 septembrie 2026, într-un articol dedicat proiectului TypeSafe și lui Diogo Almeida, cercetător care a lucrat anterior la OpenAI.

Ce este Jev și de ce este diferit de un chatbot AI?

Majoritatea modelelor AI populare sunt construite pentru a genera text. ChatGPT, Claude, Gemini și alte modele lingvistice primesc informații și produc secvențe de text, ceea ce le face extrem de flexibile pentru conversații, programare, redactare și analiză.

Jev abordează problema diferit.

Modelul dezvoltat de TypeSafe AI este conceput pentru decizii structurate pe care software-ul le poate utiliza direct. În loc să genereze un răspuns textual care trebuie ulterior interpretat și validat de un program, Jev returnează valori de tip structurat și probabilități asociate deciziilor. TypeSafe numește această categorie de modele AI „System One Models”.

Conceptul este important pentru automatizare. Dacă o aplicație trebuie să decidă dacă un mesaj este spam, dacă o tranzacție necesită verificare umană sau dacă un incident de securitate trebuie escaladat, nu are întotdeauna nevoie de un paragraf generat de AI. Are nevoie de o decizie clară.

De ce a creat TypeSafe un model AI care nu generează text?

Potrivit lui Diogo Almeida, fondatorul TypeSafe, problema este legată de diferența dintre ceea ce este optimizat pentru oameni și ceea ce este util pentru computere.

Almeida a lucrat anterior la OpenAI și este asociat cu dezvoltarea unor metode precum Reinforcement Learning from Human Feedback (RLHF), utilizate pentru îmbunătățirea comportamentului modelelor lingvistice. În viziunea sa, modelele au devenit foarte bune la limbaj, însă limbajul natural nu este întotdeauna interfața ideală pentru software.

TypeSafe încearcă astfel să construiască un model AI destinat în primul rând utilizării de către alte programe.

Compania spune că Jev folosește o arhitectură nouă, un mecanism de eșantionare paralelă și o metodă de antrenare numită Reinforcement Learning for Calibrated Decisions (RLCD). În loc să optimizeze generarea unor răspunsuri preferate de oameni, obiectivul este obținerea unor decizii structurate și a unor probabilități calibrate.

Cum poate Jev să reducă problema halucinațiilor AI?

Unul dintre argumentele centrale ale TypeSafe este că Jev nu generează text. Într-un LLM tradițional, modelul poate produce o afirmație incorectă, un cod greșit sau o informație inventată. Software-ul trebuie să interpreteze răspunsul și să verifice dacă acesta respectă formatul așteptat.

În cazul Jev, rezultatele sunt definite în avans. Modelul poate selecta, de exemplu, una dintre mai multe opțiuni sau poate furniza o probabilitate pentru o anumită decizie.

TypeSafe susține că această abordare elimină erorile de tip (type errors) deoarece structura rezultatului este definită înainte ca modelul să producă decizia. Compania afirmă, de asemenea, că fiecare rezultat este însoțit de o estimare a încrederii.

Este însă importantă o distincție: faptul că modelul produce rezultate structurate nu înseamnă că toate deciziile sale sunt automat corecte. Utilizatorii trebuie să stabilească praguri pentru automatizare și situațiile în care o decizie trebuie trimisă spre verificare umană.

Jev este mai rapid decât modelele AI tradiționale?

Viteza este una dintre principalele promisiuni ale TypeSafe. Compania spune că Jev poate răspunde în aproximativ 70-500 de milisecunde, în funcție de sarcină, și că abordarea sa poate fi de ordinul zecilor sau sutelor de ori mai rapidă în anumite scenarii de automatizare. Aceste valori sunt afirmații ale TypeSafe și trebuie interpretate în contextul testelor și workflow-urilor prezentate de companie, nu ca o regulă universală pentru toate aplicațiile AI.

Publicația TechCrunch relatează exemple concrete oferite de dezvoltatori. Un inginer software de la Vercel a afirmat că, într-un clasificator pentru verificarea siguranței comenzilor, trecerea de la un model OpenAI la Jev a dus la rezultate de 5 până la 18 ori mai rapide și la o acuratețe mai mare în testul respectiv. Un alt dezvoltator a comparat Jev cu Gemini pentru clasificarea e-mailurilor comerciale și a raportat un compromis între acuratețe, cost și disponibilitatea scorurilor de încredere.

Acestea sunt rezultate din teste specifice, nu benchmark-uri independente care demonstrează superioritatea generală a modelului.

Cât costă Jev?

Costul redus este o altă componentă importantă a strategiei TypeSafe. Pe pagina oficială a produsului, compania indică un preț de 42 de dolari pentru un miliard de tokeni de intrare, iar tokenii de ieșire sunt prezentați ca fiind gratuiti. TypeSafe susține că arhitectura este mult mai eficientă pentru sarcini de decizie decât modelele lingvistice tradiționale.

Pentru aplicațiile care procesează volume foarte mari de date, diferența de cost poate deveni relevantă.

De exemplu, un sistem care clasifică milioane de documente, verifică permanent fluxuri de date sau monitorizează agenți AI ar putea avea nevoie de milioane sau miliarde de evaluări. În astfel de situații, fiecare reducere a costului per operațiune poate schimba fezabilitatea economică a unui produs.

Pentru ce poate fi folosit Jev?

Jev nu încearcă să înlocuiască toate utilizările unui chatbot. Cazurile de utilizare prezentate de TypeSafe sunt concentrate pe automatizare și decizii în interiorul software-ului.

Printre exemple se află:

  • clasificarea automată a documentelor și mesajelor;
  • procesarea facturilor;
  • detectarea și prioritizarea incidentelor de securitate;
  • monitorizarea agenților AI;
  • detectarea tentativelor de jailbreak;
  • rutarea cererilor către modelul AI potrivit;
  • evaluarea riscului;
  • sisteme de scoring;
  • fluxuri software care trebuie să aleagă între mai multe acțiuni;
  • aplicații în timp real unde latența este critică.

TypeSafe prezintă inclusiv workflow-uri pentru incidente de securitate, procesarea facturilor, servicii pentru clienți și observabilitatea agenților AI.

Jev poate lucra împreună cu alte modele tip LLM

Una dintre ideile interesante este că Jev nu trebuie neapărat să înlocuiască modelele lingvistice. Modelul poate fi folosit ca un strat de verificare pentru alți agenți AI. De exemplu, un LLM poate genera un răspuns sau executa o serie de acțiuni, iar Jev poate analiza rezultatul și decide dacă acesta trebuie acceptat, respins sau trimis către un operator uman.

Această arhitectură poate fi relevantă pe măsură ce aplicațiile folosesc tot mai mulți agenți AI autonomi. În loc ca fiecare agent să fie verificat manual, un model specializat în decizii poate funcționa ca un filtru automat.

Ce înseamnă “System One Model”?

Denumirea vine din distincția popularizată de psihologul Daniel Kahneman între gândirea rapidă și intuitivă și gândirea lentă, deliberativă.

TypeSafe folosește conceptul pentru a descrie modele concentrate pe decizii rapide și structurate, spre deosebire de modelele concepute pentru raționament extins și generare de limbaj.

Jev este primul model public din această categorie dezvoltat de TypeSafe și se află, în prezent, în early access.

Ce trebuie urmărit înainte de a considera Jev o alternativă la LLM?

Cea mai importantă întrebare este dacă modelele specializate pot transforma promisiunile de eficiență în rezultate consistente în producție.

TypeSafe publică propriile evaluări și explică metodologia utilizată. Compania avertizează inclusiv asupra limitărilor evaluărilor și susține că benchmark-urile publice pot crea stimulente pentru optimizarea artificială a rezultatelor.

Prin urmare, afirmații precum „193,6x mai rapid” sau „444,6x mai ieftin” trebuie citite ca rezultate raportate de TypeSafe pentru anumite metode de lucru, nu ca o caracteristică universală a Jev în orice aplicație. Site-ul companiei prezintă aceste valori în contextul unor teste proprii.

Pentru dezvoltatori, testarea pe propriile date și propriile fluxuri de lucru rămâne esențială.

De ce acest model este important pentru viitorul inteligenței artificiale?

Jev ilustrează o idee mai largă: viitorul AI nu trebuie să fie format exclusiv din modele care dialoghează cu oamenii.

În anumite aplicații, limbajul natural poate fi o interfață inutil de costisitoare. Dacă un program are nevoie doar de răspunsul „aprobat”, „respins”, „dezvoltă” sau de o distribuție de probabilități, generarea unui paragraf întreg poate fi o etapă intermediară inutilă.

Modelul TypeSafe încearcă să mute inteligența artificială mai aproape de cod și de logica aplicațiilor: datele intră, modelul evaluează situația, iar software-ul primește o decizie structurată.

Această abordare ar putea deveni relevantă în automatizarea enterprise, cybersecurity, procesarea documentelor, agenți AI și aplicații cu cerințe stricte de latență.

Pentru moment, Jev este un produs aflat la început de drum și disponibil în early access. Însă apariția sa evidențiază o direcție importantă în industria AI: nu orice problemă are nevoie de un chatbot, iar unele dintre cele mai utile modele AI pentru software ar putea fi cele care nu generează deloc text.

Surse: typesafe.ai, techcrunch.com

PRODUSE RECOMANDATE

GPT-6 Astra: modelul OpenAI care schimbă regulile jocului

Timp de citit: 4 minutes

OpenAI a lansat GPT-6 Astra, cel mai avansat model de inteligență artificială al companiei până în prezent. Anunțat pe 3 septembrie 2026, GPT-6 Astra este conceput pentru sarcini complexe care combină raționamentul, programarea, cercetarea, utilizarea computerului și executarea unor fluxuri de lucru cu mai mulți pași.

Lansarea GPT-6 Astra marchează o schimbare importantă în evoluția modelelor AI: accentul nu mai este pus doar pe generarea de text sau răspunsuri conversaționale, ci pe capacitatea AI de a înțelege un obiectiv, de a utiliza instrumente și de a duce la capăt o activitate complexă.

Ce este GPT-6 Astra?

GPT-6 Astra este noul model de vârf dezvoltat de OpenAI pentru activități care necesită raționament avansat și execuție autonomă. Potrivit OpenAI, modelul este optimizat pentru utilizarea computerului, navigarea pe internet, software engineering, cybersecurity, cercetare științifică și activități profesionale.

Spre deosebire de modelele AI utilizate în principal pentru conversații, Astra este proiectat să lucreze cu aplicații și instrumente digitale. Poate, de exemplu, să completeze formulare online, să actualizeze informații într-un CRM, să organizeze un calendar, să efectueze cercetări online sau să analizeze date.

Această capacitate apropie noul model de conceptul de agent AI: utilizatorul oferă un obiectiv, iar modelul poate executa o serie de acțiuni pentru a ajunge la rezultatul dorit.

GPT-6 Astra: principalele noutăți

Una dintre cele mai importante îmbunătățiri este abilitatea modelului de a interacționa cu un computer și cu interfețe software. OpenAI afirmă că Astra poate efectua activități precum:

  • completarea formularelor online;
  • actualizarea bazelor de date și a sistemelor CRM;
  • cercetare pe internet;
  • analizarea datelor;
  • generarea de documente, prezentări și foi de calcul;
  • dezvoltarea și testarea unor aplicații;
  • depanarea problemelor software;
  • efectuarea unor fluxuri de lucru complexe cu mai mulți pași.

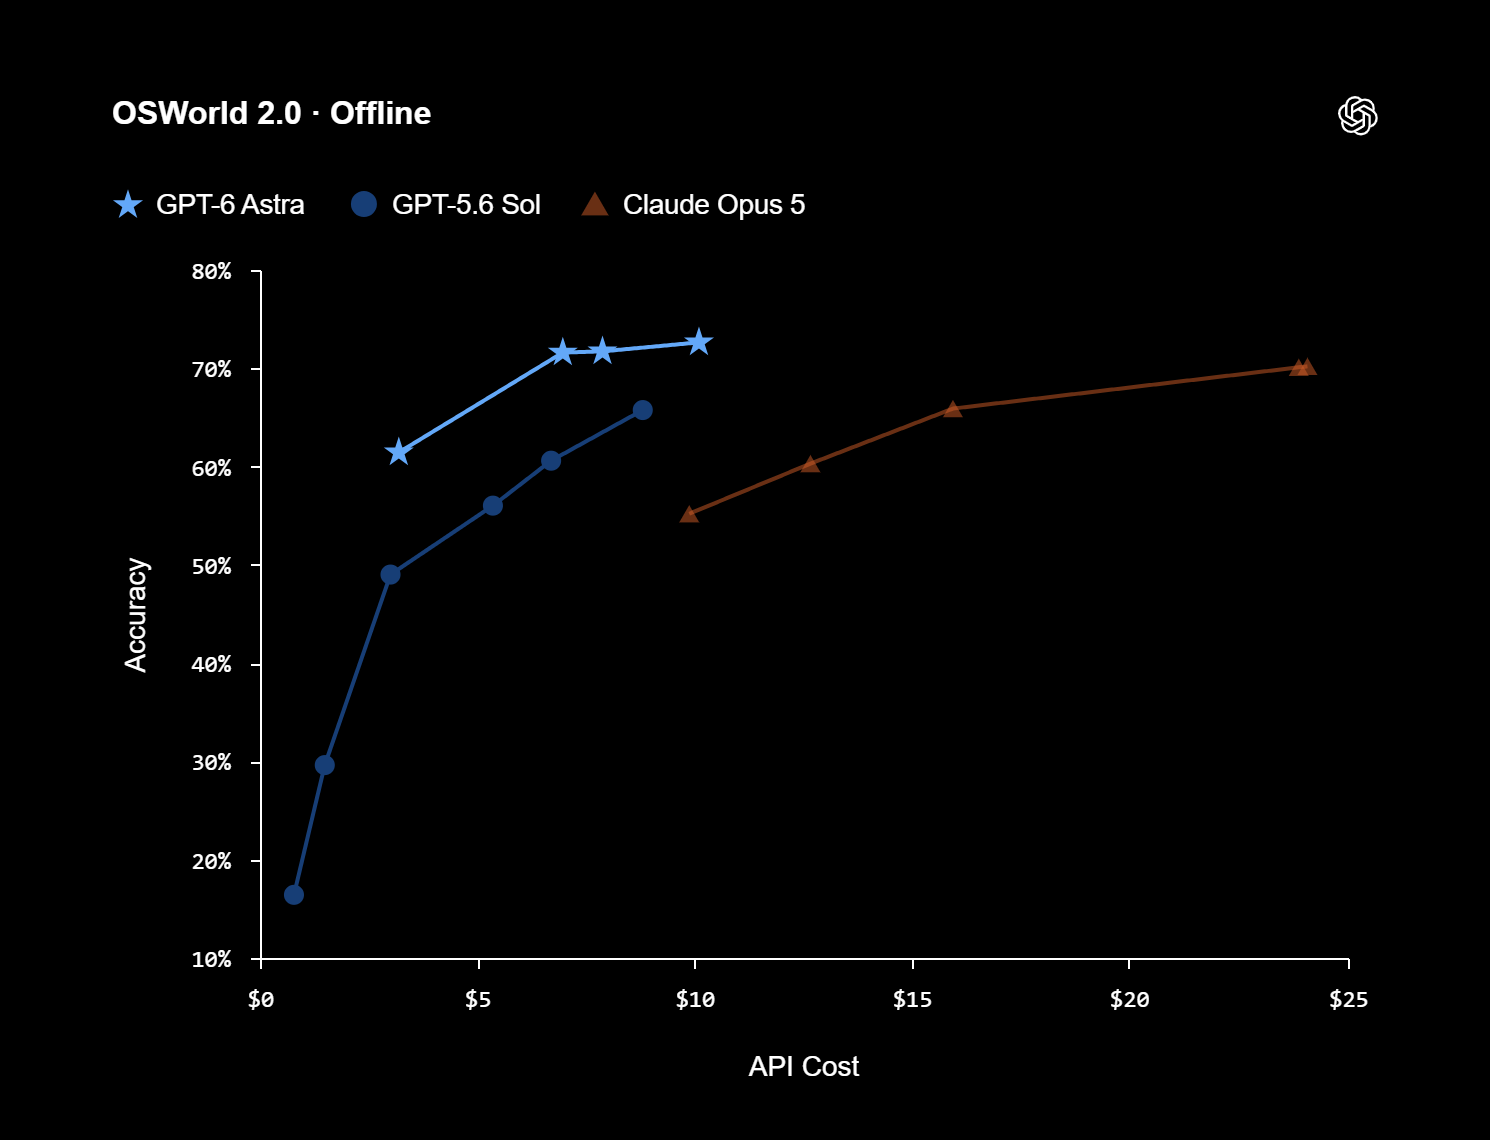
Într-o evaluare OSWorld 2.0, GPT-6 Astra a obținut un scor de 72,6%, comparativ cu 65,7% pentru GPT-5.6 Sol. OpenAI afirmă, de asemenea, că Astra poate realiza anumite sarcini de computer use în aproximativ 40 de minute, față de aproximativ 75 de minute pentru modelul anterior în simulările prezentate.

GPT-6 Astra OSWorld-2.0

GPT-6 Astra și programarea

Programarea este un alt domeniu în care GPT-6 Astra este poziționat ca model de top.

Modelul poate lucra pe proiecte software complexe, poate analiza cod, poate utiliza instrumente de dezvoltare și poate efectua verificări asupra aplicațiilor. OpenAI îl prezintă drept un model destinat nu doar generării de fragmente de cod, ci executării unor workflow-uri software end-to-end.

Această diferență este importantă pentru dezvoltatori. În loc să ceară AI-ului doar să scrie o funcție, utilizatorul poate delega o problemă mai amplă: analizarea unui proiect, implementarea unei modificări, testarea rezultatului și identificarea erorilor.

Performanțe ridicate în benchmark-uri

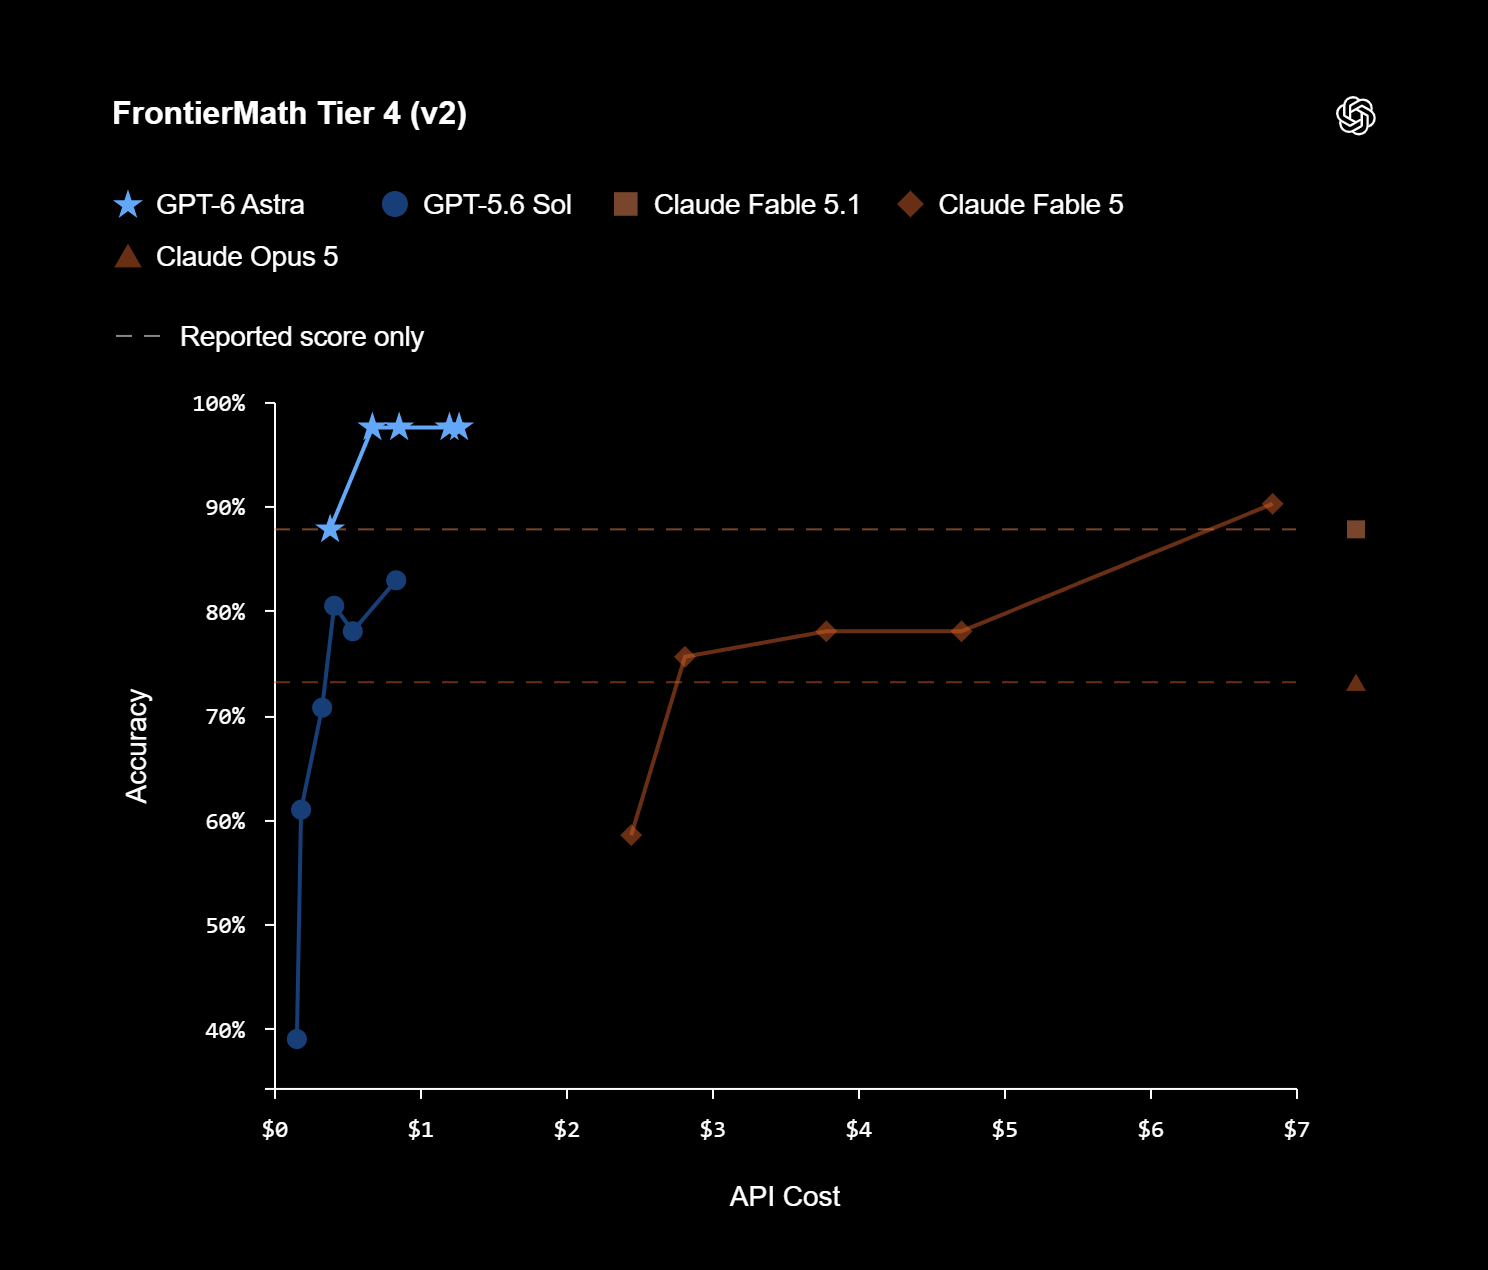
OpenAI susține că noul model stabilește rezultate de top în mai multe evaluări. Printre cifrele prezentate de companie se numără 99,9% pe ARC-AGI-3, 98% pe FrontierMath Tier 4 și 100% pe ExploitBench.

FrontierMath-Tier-4-v2

Este important însă ca aceste rezultate să fie interpretate în context: benchmark-urile sunt evaluări controlate, iar performanța într-un test nu garantează automat aceleași rezultate în orice situație reală.

GPT-6 Astra și securitatea cibernetică

Creșterea capacităților modelului vine și cu riscuri mai mari. OpenAI afirmă că este primul său model care atinge nivelul „Critical” pentru capacitățile de cybersecurity în cadrul Preparedness Framework. Compania spune că modelul poate identifica vulnerabilități de securitate necunoscute anterior și poate dezvolta metode de exploatare atunci când dispune de instrumentele și accesul necesare.

Din acest motiv, GPT-6 Astra include mecanisme suplimentare de monitorizare. OpenAI spune că anumite conversații sau activități pot fi întrerupte dacă sistemele detectează un posibil comportament problematic sau o interpretare greșită a instrucțiunilor.

Această componentă de siguranță devine tot mai importantă pe măsură ce modelele AI trec de la generarea de conținut la executarea unor acțiuni în lumea digitală.

Când este disponibil GPT-6 Astra?

Lansarea GPT-6 Astra se face gradual. OpenAI a început cu acces pentru un număr limitat de organizații, urmând ca modelul să fie disponibil mai larg pentru utilizatorii ChatGPT Plus, Pro, Business și Enterprise. Astra este disponibil și prin OpenAI API, Microsoft Azure și Amazon Bedrock.

Pentru dezvoltatori, modelul este identificat în API drept 

gpt-6-astra

. Documentația oficială indică o fereastră de context de până la 1.050.000 de tokeni și un maximum de 128.000 de tokeni pentru output. Prețul standard API este de 10 dolari pentru un milion de tokeni de input și 50 de dolari pentru un milion de tokeni de output.

Cât costă GPT-6 Astra?

Pentru API, prețul anunțat de OpenAI este:

  • Input: 10 USD / 1 milion de tokeni;
  • Cached input: 1 USD / 1 milion de tokeni;
  • Output: 50 USD / 1 milion de tokeni.

Există și un mod Fast, care poate oferi viteze de procesare mai mari, la un cost suplimentar.

Pentru utilizatorii ChatGPT, accesul este condiționat de nivelul abonamentului și de disponibilitatea progresivă a modelului.

Un pas către AGI?

Una dintre cele mai interesante întrebări este dacă modelul reprezintă un pas către Artificial General Intelligence (AGI).

OpenAI descrie Astra drept o nouă generație de inteligență și îl prezintă ca pe un model capabil să gestioneze o gamă foarte largă de activități intelectuale și profesionale. Totuși, termenul AGI nu are o definiție tehnică universal acceptată, iar performanțele ridicate ale unui model nu înseamnă automat că AGI a fost atins.

Ceea ce este mai ușor de observat este schimbarea de paradigmă: AI-ul devine tot mai capabil să execute sarcini, nu doar să ofere răspunsuri.

Ce înseamnă GPT-6 Astra pentru utilizatorii obișnuiți?

Pentru utilizatorul obișnuit, impactul GPT-6 Astra poate fi mai important în zona de automatizare decât în conversațiile clasice.

În viitorul apropiat, un utilizator ar putea solicita AI-ului să cerceteze un subiect, să compare informațiile, să organizeze rezultatele într-un document și să pregătească o prezentare. În mediul profesional, astfel de capabilități pot reduce timpul petrecut pentru activități repetitive și administrative.

Pentru companii, valoarea potențială este și mai mare: modelul poate fi integrat în fluxuri de lucru care implică documente, software, internet, date interne și aplicații de business.

Mai mult decât un simplu chatbot

GPT-6 Astra este mai mult decât o versiune nouă a unui chatbot. Direcția prezentată de OpenAI este aceea a unor sisteme AI capabile să raționeze, să utilizeze instrumente și să execute procese complexe de la început până la sfârșit.

Performanțele raportate în programare, folosirea computerului, cercetare, raționament și activități profesionale indică un progres semnificativ. În același timp, nivelul crescut de capabilități în securitatea cibernetică și nevoia de monitorizare suplimentară arată că progresul AI vine împreună cu provocări importante de siguranță.

Pentru utilizatori și companii, întrebarea nu mai este doar „Ce poate genera AI?” ci „Ce activități pot delega inteligenței artificiale în siguranță?„. GPT-6 Astra reprezintă una dintre cele mai clare încercări de până acum de a răspunde la această întrebare.

Sursa informațiilor: openai.com

PRODUSE RECOMANDATE