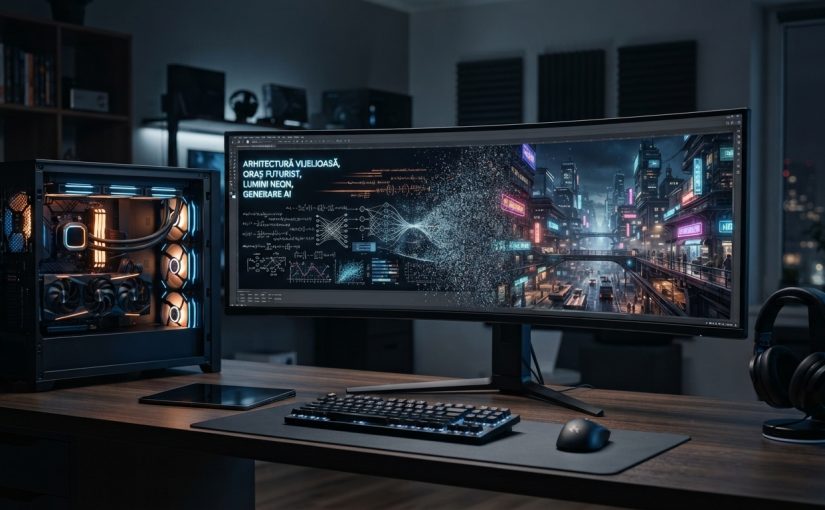
Scrii câteva cuvinte precum „un oraș futurist noaptea, văzut de sus, cu mașini zburătoare și lumini neon”, apeși un buton și, câteva secunde mai târziu, ai o imagine care pare desprinsă dintr-un film SF.
Dar cum creează AI imagini pornind de la o simplă descriere?
Nu există un designer ascuns într-un server care desenează frenetic cu mouse-ul. 😂 În spatele imaginilor generate de AI se află modele matematice complexe, antrenate pe cantități uriașe de date și capabile să învețe relațiile dintre cuvinte și elementele vizuale.
Hai să vedem ce se întâmplă în momentul în care introduci un prompt.
Ce înseamnă generarea de imagini cu AI?
Generarea de imagini cu AI este procesul prin care un model de inteligență artificială creează o imagine pe baza unei instrucțiuni.
Instrucțiunea poate fi foarte simplă:
„O pisică pe un skateboard.”
sau extrem de detaliată:
„Un laptop premium pe un birou minimalist, lumină cinematografică, fundal întunecat, fotografie de produs, reflexii subtile.”
Modelul încearcă să transforme aceste informații într-o reprezentare vizuală.
În funcție de tehnologia folosită, poate genera imagini fotorealiste, ilustrații, randări 3D, picturi digitale sau stiluri complet diferite.
Cum învață AI-ul să creeze imagini?
Pentru ca un model să poată genera imagini, trebuie mai întâi să fie antrenat.
În timpul procesului de antrenare, modelul este expus la cantități foarte mari de informații vizuale și textuale.
În termeni simplificați, poate învăța că anumite cuvinte și concepte sunt asociate cu anumite caracteristici vizuale.
De exemplu:
„câine”
poate fi asociat cu forme, texturi, poziții și caracteristici vizuale întâlnite în numeroase imagini.
„zăpadă”
poate fi asociată cu anumite culori, texturi și contexte.
„mașină sport roșie”
poate fi asociată cu forme specifice, caroserie, roți, reflexii și culoarea roșie.
Modelul nu memorează pur și simplu fiecare fotografie.
Învață tipare și relații din datele folosite la antrenare.
Ce se întâmplă când scrii un prompt?
Să presupunem că scrii:
„Un robot care bea cafea într-o cafenea din București.”
Primul pas este ca sistemul să proceseze textul.
Cuvintele sunt transformate într-o reprezentare pe care modelul o poate utiliza matematic.
Modelul trebuie să înțeleagă relațiile dintre concepte:
robot
- bea cafea
- cafenea
- București
Nu este suficient să știe ce înseamnă fiecare cuvânt separat.
Trebuie să construiască o imagine în care aceste elemente apar împreună într-un mod coerent.
De la text la imagine
Aici apare partea cu adevărat interesantă.
Multe sisteme moderne de generare a imaginilor folosesc metode bazate pe modele de difuzie.
Ideea poate fi explicată surprinzător de simplu.
Modelul pornește de la o reprezentare care seamănă cu zgomotul vizual.
Apoi începe să o transforme treptat într-o imagine care corespunde descrierii tale.
Imaginează-ți că ai un televizor fără semnal plin de purici.
La început:
📺 zgomot
Apoi, treptat, începe să apară:
🌫️ forme
↓
🏙️ obiecte
↓
🤖 detalii
↓
☕ texturi și lumină
↓
🖼️ imaginea finală
Procesul real este mult mai complex, dar această analogie ajută la înțelegerea principiului.
Ce este un model de difuzie?
Un model de difuzie este un tip de model generativ care învață să transforme treptat zgomotul într-o reprezentare coerentă.
În timpul antrenării, modelul poate învăța cum arată procesul de degradare a unei imagini prin adăugarea de zgomot și, invers, cum poate fi eliminat acel zgomot pentru a reconstrui structuri vizuale.
La generare, procesul este folosit în direcția opusă.
Modelul pornește de la zgomot și îl rafinează pas cu pas.
La fiecare etapă, încearcă să apropie rezultatul de ceea ce ai cerut în prompt.
De ce contează atât de mult promptul?
Promptul este practic instrucțiunea pe care o primește modelul.
Cu cât descrierea este mai clară, cu atât poți controla mai bine rezultatul.
De exemplu:
Prompt simplu:
„Un laptop pe un birou.”
Poți obține aproape orice interpretare.
Dar:
„Laptop premium argintiu pe un birou modern din lemn, fotografie de produs, lumină naturală din lateral, fundal minimalist, perspectivă 45 de grade, profunzime de câmp redusă.”
oferă mult mai multe informații.
Poți controla:
- subiectul;
- poziția;
- mediul;
- iluminarea;
- perspectiva;
- stilul;
- atmosfera;
- nivelul de realism.
AI-ul chiar „desenează” imaginea?
Nu în sensul clasic.
Un model generativ nu funcționează ca un om care ia un creion și începe să traseze contururi.
El operează cu reprezentări matematice și transformă progresiv acestea într-o reprezentare vizuală.
De aceea poate genera în același timp:
- obiecte;
- texturi;
- umbre;
- lumini;
- perspective;
- fețe;
- peisaje;
- materiale.
Toate sunt tratate ca parte a unei structuri vizuale complexe.
Cum știe AI-ul că un obiect trebuie să fie acolo?
Pentru că în timpul antrenării a învățat relații între concepte.
Dacă modelul a întâlnit foarte multe exemple asociate cu:
„mașină”
poate învăța caracteristicile vizuale asociate cu acel concept.
Dacă primește:
„mașină roșie într-un garaj”
trebuie să combine mai multe concepte.
Aici intervine una dintre marile performanțe ale modelelor moderne: capacitatea de a combina concepte pe care nu le-a întâlnit neapărat exact în aceeași configurație.
De ce apar uneori mâini ciudate sau obiecte deformate?
Pentru că generarea unei imagini este o problemă extrem de complexă.
Mâna umană, de exemplu, are:
- cinci degete;
- articulații;
- poziții foarte variate;
- perspective complicate;
- interacțiuni cu obiectele.
Pentru un model, toate acestea trebuie reprezentate vizual într-un mod coerent.
Dacă modelul nu reușește să respecte toate relațiile, rezultatul poate avea:
🖐️ șase degete
👀 ochi poziționați ciudat
🪑 obiecte deformate
🚗 roți imposibile
Deși modelele moderne au devenit mult mai bune la aceste lucruri, astfel de erori pot apărea în continuare.
Dar cum poate AI-ul să creeze stiluri diferite?
Pentru că în datele de antrenare există foarte multe tipuri de reprezentări vizuale.
Modelul poate învăța caracteristici asociate cu:
- fotografie;
- pictură;
- ilustrație;
- desen;
- randare 3D;
- artă digitală;
- design minimalist;
- fotografie de produs.
Atunci când specifici un anumit stil, modelul încearcă să genereze imaginea în direcția respectivă.
Poate AI-ul să creeze orice imagine?
Nu chiar.
Există limite tehnice și de siguranță.
În plus, unele concepte sunt pur și simplu mai greu de reprezentat.
Un prompt foarte vag sau contradictoriu poate produce rezultate mai puțin precise.
De exemplu:
„Un laptop transparent, din metal lichid, care plutește sub apă și funcționează fără baterie.”
AI-ul poate încerca să reprezinte conceptul.
Dar rezultatul poate deveni mai degrabă o interpretare artistică decât o reprezentare realistă.
De ce imaginile generate de AI arată din ce în ce mai bine?
Pentru că modelele și metodele de generare au evoluat foarte mult.
Modelele moderne sunt capabile să înțeleagă mai bine:
- relațiile spațiale;
- compoziția;
- iluminarea;
- obiectele;
- anatomia;
- materialele;
- stilurile vizuale.
În plus, procesoarele grafice și centrele de date au devenit suficient de puternice pentru a rula modele extrem de complexe.
Aici se întâlnesc două lumi:
AI + hardware performant.
De ce are nevoie AI-ul de GPU-uri atât de puternice?
Generarea unei imagini presupune efectuarea unui număr foarte mare de operații matematice.
GPU-urile sunt excelente la procesarea paralelă.
În loc să execute o operație după alta, pot efectua foarte multe operații simultan.
Exact această caracteristică le face extrem de utile pentru:
- AI;
- machine learning;
- generare de imagini;
- procesare video;
- simulări;
- calcul științific.
De aceea, plăcile video moderne au devenit atât de importante în dezvoltarea AI.
Poți genera imagini AI direct pe calculator?
Da.
Unele modele pot rula local, direct pe PC, fără ca imaginea să fie generată pe un server din cloud.
Avantajul?
Poți avea mai mult control asupra procesului și asupra datelor.
Dezavantajul?
Ai nevoie de hardware suficient de performant, în special de o placă video cu suficientă memorie.
Pentru modele mai complexe, cerințele hardware pot crește foarte mult.
AI-ul înlocuiește fotografia și designul?
Nu neapărat.
Mai degrabă schimbă modul în care sunt realizate anumite tipuri de conținut.
Un designer poate folosi AI pentru:
- brainstorming;
- concepte vizuale;
- mockup-uri;
- fundaluri;
- variante de design;
- prezentări.
Un fotograf poate folosi AI pentru anumite etape de editare.
Un magazin online poate genera concepte vizuale pentru produse.
În multe situații, AI-ul devine mai degrabă un instrument decât un înlocuitor complet.
Unde este folosită deja generarea de imagini cu AI?
Tehnologia este deja prezentă în foarte multe domenii.
🎨 Design
Pentru concepte și materiale vizuale.
📢 Marketing
Pentru reclame, bannere și campanii.
🛒 E-commerce
Pentru imagini de prezentare și materiale promoționale.
🎮 Gaming
Pentru concepte de personaje, medii și obiecte.
🎬 Film
Pentru concept art și pre-vizualizare.
🏢 Arhitectură
Pentru idei de amenajare și vizualizări conceptuale.
📱 Social media
Pentru conținut vizual creat rapid.
Ce urmează?
Generarea de imagini este doar una dintre direcțiile AI generativ.
Modelele devin din ce în ce mai capabile să lucreze cu:
text + imagine + audio + video + cod
în același timp.
Asta înseamnă că viitoarele sisteme ar putea primi o simplă descriere și să genereze nu doar o imagine, ci o întreagă experiență vizuală interactivă.
Practic, de la:
„fă-mi o imagine”
putem ajunge la:
„construiește-mi lumea asta.”
Și aici începe partea cu adevărat interesantă.
Concluzie
Cum creează AI imagini?
Pe scurt, modelele moderne analizează descrierea introdusă de utilizator și o transformă într-o reprezentare pe care o pot folosi pentru a ghida procesul de generare.
În cazul modelelor bazate pe difuzie, imaginea este construită progresiv pornind de la zgomot, până când rezultatul corespunde cât mai bine promptului.
Nu există un artist ascuns în server. 😂
Există matematică, foarte multă putere de calcul, modele antrenate pe cantități uriașe de date și algoritmi capabili să transforme cuvintele în imagini.
Iar partea fascinantă este că procesul care pare magie pentru utilizator este, în realitate, una dintre cele mai interesante combinații dintre matematică, informatică și inteligență artificială.