OpenAI introduce un watermark pentru textele generate de AI

Timp de citit: 5 minutes

OpenAI introduce o nouă tehnologie de proveniență a textului generat de inteligența artificială în Uniunea Europeană. Începând din octombrie 2026, compania anunță implementarea treptată a unui watermark invizibil pentru anumite texte generate de ChatGPT și Codex în UE, ca parte a răspunsului la cerințele de transparență din EU AI Act.

Noua tehnologie se numește textGrain și folosește un semnal statistic integrat în modul în care modelul alege cuvintele. Scopul acestei tehnologii nu este de a altera în mod vizibil textul generat, ci de a integra un semnal digital care poate fi identificat ulterior de un detector specializat pentru a determina dacă un pasaj a fost generat de un model OpenAI.

Potrivit anunțului oficial OpenAI, această măsură face parte dintr-o strategie mai amplă privind proveniența conținutului digital, prin care utilizatorii, organizațiile, platformele și cercetătorii pot obține mai multe informații despre originea și modul în care a fost generat sau modificat un anumit conținut.

Ce este, de fapt, acest watermark ?

Un watermark AI pentru text este un semnal incorporat în text într-un mod care nu este vizibil pentru cititor. În cazul OpenAI, tehnologia textGrain ajustează subtil modul în care modelul selectează între variantele posibile de cuvinte sau fragmente de cuvinte.

Pe parcursul unui pasaj suficient de lung, aceste alegeri pot forma un tipar statistic pe care un detector îl poate identifica. Important este că watermark-ul nu presupune caractere ascunse, spații invizibile sau semne de punctuație neobișnuite. Potrivit documentației OpenAI, semnalul face parte din alegerile de cuvinte ale modelului.

De ce introduce OpenAI această tehnologie?

Principalul motiv este transparența privind conținutul generat de inteligența artificială. EU AI Act introduce cerințe pentru ca anumite tipuri de conținut generat de AI să poată fi identificate într-un mod care poate fi procesat de sisteme informatice.

OpenAI a declarat că abordarea sa pentru text urmărește aceste cerințe, dar ține cont și de limitele actuale ale tehnologiei de watermarking și detecție.

Cum funcționează textGrain?

Conceptul este relativ simplu: în timpul generării textului, textGrain influențează statistic anumite alegeri de cuvinte ale modelului, fără să modifice în mod vizibil rezultatul pentru utilizator.

Prin urmare, textGrain este un filigran digital integrat în textul generat de modelele OpenAI, conceput pentru a permite identificarea unui semnal asociat procesului de generare. Spre deosebire de detectoarele tradiționale care analizează dacă un text „sună ca AI”, textGrain urmărește un tipar statistic specific modului în care modelul OpenAI selectează și generează cuvintele.

Această diferență este importantă. Un detector de watermark nu ar trebui interpretat ca un instrument universal care stabilește dacă orice text a fost scris de inteligența artificială.

Cât de precis este detectorul OpenAI?

OpenAI subliniază că watermarking-ul și detecția textului generat de AI sunt tehnologii aflate încă într-o etapă timpurie și, care, evident, au limitări.

În evaluările prezentate de companie, detectorul a identificat watermark-ul în aproximativ 80% dintre pasajele de 200 de tokeni la o rată-țintă de fals pozitive de 1%. Pentru pasaje de aproximativ 400 de tokeni, rata de detectare a ajuns la aproximativ 95% în anumite teste. Rezultatele au fost însă mai slabe pentru domenii precum matematica, unde există mai puțină flexibilitate în alegerea cuvintelor.

Lungimea textului este, astfel, un factor important. Cu cât pasajul este mai scurt sau mai constrâns lingvistic, cu atât identificarea semnalului poate deveni mai dificilă.

Editarea poate elimina sau slăbi watermark-ul

Un alt aspect esențial este editarea. În testele OpenAI, înlocuirea a aproximativ 10% dintre cuvintele unui pasaj de 400 de tokeni a redus detectarea watermark-ului de la aproximativ 92% la 66%. Când au fost înlocuite 25% dintre cuvinte, detectarea a scăzut până la aproximativ 17%.

Acest lucru arată de ce rezultatul unui detector trebuie interpretat cu prudență. Un text modificat substanțial nu mai oferă neapărat același semnal statistic ca textul original generat de model.

Un watermark nu poate quantifica contribuția umană

Aceasta este una dintre cele mai importante precizări făcute de OpenAI. Prezența unui watermark poate doar indica faptul că un sistem OpenAI a generat sau a procesat o parte din text, însă nu poate măsura contribuția umană. Nu poate spune cât de mult a editat, verificat sau rescris textul o persoană.

De exemplu, un articol poate fi generat inițial cu ajutorul AI și apoi verificat, documentat și rescris substanțial de un jurnalist sau specialist. Watermark-ul nu oferă o măsură exactă a contribuției fiecărei părți.

Poate acest watermark să indice cine a folosit ChatGPT?

OpenAI precizează explicit că watermark-ul nu identifică utilizatorul, contul, promptul sau conversația din care provine textul.

Prin urmare, identificarea unui watermark nu înseamnă că detectorul poate spune cine a generat textul sau ce instrucțiuni au fost utilizate.

Prezența unui watermark nu stabilește dacă informațiile prezentate în text sunt adevărate

Un semnal de proveniență oferă informații despre originea probabilă a conținutului, nu despre calitatea sau veridicitatea lui. OpenAI precizează că watermark-ul este o simplă măsura birocratică. Acesta nu verifică acuratețea, nu stabilește dacă informația este adevărată sau falsă și nu confirmă faptul că textul este prezentat în contextul corect.

Această distincție este esențială într-un ecosistem în care conținutul generat de AI poate fi distribuit rapid. Proveniența nu este același lucru cu adevărul.

Ce se întâmplă dacă un text nu are watermark?

Absența unui watermark nu dovedește că textul a fost scris de o persoană. Un detector poate să nu identifice watermark-ul deoarece textul este prea scurt, a fost editat sau tradus, provine de la un model care nu utilizează tehnologia respectivă ori a fost generat înainte de implementarea watermark-ului.

De asemenea, un text poate proveni de la un alt furnizor de AI. Acest marcaj este important pentru publicații, profesori, companii și organizații care iau decizii pe baza instrumentelor de detectare AI.

Unde va fi folosit watermark-ul textGrain?

OpenAI anunță o implementare în etape. Pentru utilizatorii din Uniunea Europeană, compania spune că va introduce în următoarele săptămâni watermarking pentru textele eligibile generate de ChatGPT și Codex, pe toate planurile disponibile în UE.

În paralel, clienții API din întreaga lume vor putea opta pentru watermark în cazul anumitor modele. Pentru API, funcția va fi disponibilă inițial opțional, nu activată implicit. OpenAI pregătește și accesul la detector pentru cercetători și organizații specializate, inițial printr-un proces de aprobare.

Ce înseamnă această schimbare pentru creatorii de conținut?

Pentru bloggeri, agenții, publisheri, departamente de marketing și companii care folosesc AI pentru redactare, schimbarea aduce un nivel suplimentar de transparență.

Este important însă să nu confundăm utilizarea AI cu lipsa contribuției umane. Un workflow profesionist poate include cercetare umană, generare asistată de AI, verificarea surselor, editare, fact-checking, optimizare SEO și revizie editorială.

Watermark-ul nu poate descrie singur întregul proces. Pentru conținutul destinat publicării, bunele practici rămân aceleași: verificarea informațiilor, utilizarea surselor credibile, citarea surselor primare și asumarea editorială a materialului.

Cum se leagă textGrain de C2PA și Content Credentials?

Watermark-ul pentru text este doar o componentă a strategiei OpenAI privind proveniența conținutului.

Pentru imagini și alte tipuri de media, OpenAI utilizează și Content Credentials, bazate pe standardul deschis C2PA, precum și watermarking SynthID pentru anumite tiouri de conținut. Content Credentials pot furniza informații despre originea și istoricul unui fișier, în timp ce watermark-urile pot oferi un semnal care rămâne prezent chiar dacă anumite metadate sunt eliminate.

OpenAI descrie această strategie drept o abordare multistrat a provenienței. Ideea centrală este simplă: nicio metodă individuală nu este suficientă în toate situațiile.

De ce este importantă proveniența conținutului AI?

Pe măsură ce inteligența artificială generativă devine parte din fluxurile de lucru pentru text, imagine și audio, devine tot mai dificil pentru utilizatori să determine originea unui material doar prin inspecție vizuală sau lingvistică.

Sistemele de proveniență pot oferi platformelor, cercetătorilor, jurnaliștilor și utilizatorilor informații suplimentare despre modul în care a fost creat sau modificat conținutul. OpenAI consideră că aceste semnale pot contribui la reducerea confuziei și la o mai bună înțelegere a originii conținutului online.

În esență, obiectivul nu este să existe un verdict simplist de tipul „AI” sau „om”, ci să existe mai mult context despre originea conținutului digital. Pentru organizații și creatori, aceasta înseamnă că transparența, verificarea surselor și responsabilitatea editorială vor deveni tot mai importante într-un ecosistem în care conținutul generat de AI este din ce în ce mai prezent.

Sursa: openai.com

PRODUSE RECOMANDATE

Google a lansat Gemini 3.8 Live cu Live Avatar

Timp de citit: 4 minutes

Gemini 3.8 Live cu Live Avatar este cea mai recentă tehnologie prezentată de Google pentru conversații cu inteligența artificială. Noua funcționalitate adaugă o prezență vizuală aproape în timp real conversațiilor cu AI, combinând dialogul vocal cu video generat în timp real.

Google a anunțat Gemini 3.8 Live cu Live Avatar pe 24 septembrie 2026, prezentând tehnologia ca o modalitate prin care conversațiile cu agenții AI pot deveni mai naturale, mai interactive și mai apropiate de modul în care comunică oamenii. Funcționalitatea este disponibilă, la lansare, în Gemini Enterprise.

Ce este Gemini 3.8 Live cu Live Avatar?

Gemini 3.8 Live cu Live Avatar combină capabilitățile de dialog live ale modelelor Gemini cu streaming video cu latență redusă. Rezultatul este un avatar digital interactiv, capabil să comunice prin voce și imagine, oferind o experiență vizuală dinamică și cât mai naturală.

Potrivit Google, sistemul utilizează simultan informații audio și vizuale pentru a genera conversații mai bogate. Avatarul poate avea expresii naturale, sincronizare precisă și un mecanism fluid de alternare a replicilor, cunoscut drept turn-taking.

Această abordare marchează o schimbare importantă față de interacțiunea tradițională cu un chatbot. În locul unei experiențe bazate exclusiv pe text sau voce, utilizatorul poate interacționa cu o prezență vizuală animată, capabilă să răspundă într-un mod mai apropiat de o conversație față în față.

Cum funcționează Live Avatar?

Unul dintre elementele centrale ale tehnologiei este combinarea procesării audio și video aproape în timp real.

Google explică faptul că Live Avatar poate procesa simultan ceea ce „vede” și ceea ce „aude”, apoi poate genera răspunsuri sub forma unei combinații de audio expresiv și video. Astfel, conversația nu mai este doar o succesiune de întrebări și răspunsuri, ci poate include elemente vizuale și expresive.

Un alt aspect important este sincronizarea cu vocea. Pentru aplicațiile comerciale, acest detaliu poate contribui la o interacțiune mai naturală, deoarece mișcările avatarului sunt coordonate cu discursul generat de AI.

Google menționează, de asemenea, expresii naturale și interacțiuni fluide, caracteristici concepute pentru a face agenții virtuali mai potriviți pentru scenarii în care comunicarea directă cu utilizatorul este importantă.

Gemini 3.8 Live poate executa sarcini în timpul conversației

O funcție interesantă prezentată de Google este procesarea sarcinilor în mod asincron (asynchronous tool execution).

Practic, Live Avatar poate iniția apeluri către instrumente și poate obține informații în fundal, în timp ce conversația cu utilizatorul continuă. Acest mecanism permite agentului AI să gestioneze sarcini mai complexe fără să întrerupă complet dialogul.

Google oferă drept exemplu un scenariu în care un agent poate contribui la cazarea unui turist la hotel. În timp ce sistemul execută operațiunile necesare în fundal, dialogul poate continua.

Pentru companii, această caracteristică poate fi relevantă în aplicații precum servicii pentru clienți, asistenți virtuali, ghiduri interactive și alte fluxuri în care AI-ul trebuie să combine conversația cu accesarea unor instrumente sau date.

Live Avatar este disponibil în 97 de limbi

Un alt element evidențiat de Google este componenta multilingvă. Gemini 3.8 Live cu Live Avatar oferă sincronizare nativă speech-to-speech în mai multe limbi și poate face tranziția între limbi în timpul unei conversații. Google afirmă că Live Avatar poate adapta sincronizarea buzelor și expresiile la schimbarea limbii și poate funcționa în 97 de limbi, fără degradarea fidelității video sau apariția unui fenomen denumit de companie visual drift.

Această caracteristică este relevantă în special pentru organizațiile care operează internațional. Un agent virtual poate fi conceput pentru interacțiuni cu utilizatori din piețe diferite, fără ca experiența să fie limitată la o singură limbă.

Avataruri personalizabile pentru companii

Gemini 3.8 Live cu Live Avatar nu se limitează la o colecție de personaje standard. Google precizează că organizațiile pot utiliza avataruri presetate, dar pot și personaliza Live Avatars. Pornind de la o imagine de referință de calitate ridicată, dezvoltatorii pot genera un avatar animat și reactiv, păstrând asemănarea cu imaginea de referință, stilul vizual al unui brand sau identitatea unui personaj.

Totuși, există o limitare importantă: potrivit informațiilor oficiale Google, crearea de avataruri personalizate este disponibilă în prezent doar pentru companiile aprobate în prealabil de Google..

Prin urmare, este important să nu confundăm disponibilitatea tehnologiei cu accesul universal la toate funcțiile sale.

Siguranță și transparență: utilizarea SynthID

Google include și o componentă de siguranță și transparență în arhitectura Live Avatar. Compania afirmă că toate rezultatele generate de produsele sale AI sunt marcate cu SynthID, un watermark imperceptibil integrat în conținutul audio și video. Potrivit Google, această tehnologie este concepută pentru a permite detectarea conținutului generat de AI și pentru a contribui la reducerea riscului de dezinformare și atribuire greșită.

Pentru aplicațiile enterprise, această componentă este relevantă deoarece conținutul generat de inteligența artificială poate ajunge să fie utilizat în interacțiuni directe cu clienții sau în fluxuri comerciale.

Pentru ce poate fi folosit Gemini 3.8 Live cu Live Avatar?

Din exemplele prezentate de Google, tehnologia poate fi relevantă pentru mai multe tipuri de experiențe digitale:

  • servicii de relații cu clienții și asistență virtuală;
  • ghiduri interactive pentru utilizatori;
  • agenți AI pentru companii;
  • interacțiuni digitale prin intermediul avatarurilor;
  • interacțiuni multilingve;
  • prezentări și demonstrații interactive;
  • servicii pentru industria hotelieră;
  • aplicații care combină conversația AI cu apeluri către instrumente externe.

Un avantaj al abordării este că agentul AI nu trebuie să aleagă între conversație și executarea unei sarcini. Prin apelurile asincrone către instrumente, anumite operațiuni pot fi executate în fundal, în timp ce interacțiunea cu utilizatorul continuă.

Ce înseamnă Gemini 3.8 Live pentru viitorul AI conversațional?

Gemini 3.8 Live cu Live Avatar indică o direcție în care interacțiunea cu inteligența artificială devine din ce în ce mai multimodală.

Chatboții tradiționali se bazează în principal pe text. Sistemele voice AI au adăugat conversația vocală. Live Avatar adaugă încă un nivel: prezența vizuală dinamică, sincronizată cu vocea și capabilă să reacționeze în timpul conversației.

Din punct de vedere tehnologic, combinația dintre audio, video, raționament și executarea asincronă a instrumentelor poate transforma agentul AI dintr-un simplu sistem de răspuns într-o interfață conversațională pentru servicii digitale.

Este însă important de precizat că informațiile disponibile în acest moment provin din prezentarea oficială Google, iar performanța în scenarii reale poate depinde de implementare, infrastructură, integrarea cu instrumentele companiei și cazul concret de utilizare.

Live Avatar extinde conceptul de agent conversațional

Gemini 3.8 Live cu Live Avatar aduce o componentă vizuală aproape în timp real în conversațiile cu AI, oferind o experiență care merge dincolo de interacțiunea prin text și voce.

La momentul anunțului, Gemini 3.8 Live cu Live Avatar este disponibil în Gemini Enterprise, iar personalizarea avatarurilor este disponibilă prin enterprise allowlisting.

Pentru companii, evoluția este relevantă deoarece deschide posibilitatea unor interacțiuni AI mai vizuale, mai naturale și mai interactive. Pentru utilizatori, direcția indicată de Google sugerează că următoarea etapă a inteligenței artificiale conversaționale nu va însemna doar răspunsuri mai bune, ci și moduri mai naturale de a interacționa cu agenții AI.

Sursa: Google Blog

PRODUSE RECOMANDATE

Poate AI-ul să cumpere ceva online în locul tău?

Timp de citit: 4 minutes

Imaginează-ți că îi spui unui AI: „Am nevoie de un monitor de 27 de inch, pentru birou, până în 1.500 de lei”. În loc să îți ofere doar câteva recomandări, AI-ul caută produsele, compară prețurile, verifică specificațiile, intră pe magazinul online, adaugă produsul în coș și ajunge chiar până la finalizarea comenzii.

Sună ca un scenariu dintr-un film SF? Nu chiar.

Pe măsură ce AI-ul trece de la simpla conversație la agenți AI capabili să execute acțiuni, cumpărăturile online sunt una dintre activitățile care pot fi automatizate tot mai mult. Dar există o diferență importantă între faptul că AI-ul poate face tehnic o comandă și faptul că ar trebui să îi permiți să o facă fără verificarea ta.

AI-ul poate doar să recomande sau poate cumpăra efectiv?

Până nu demult, un asistent AI era în principal un instrument de informare.

Îi puteai spune:

„Vreau un laptop pentru facultate, până în 3.000 de lei.”

AI-ul putea să îți explice ce procesor să alegi, cât RAM este suficient, ce diferențe există între modele și chiar să compare mai multe produse.

Asta este partea de recomandare.

Un agent AI poate merge mai departe. Dacă are acces la instrumentele necesare, poate naviga pe site-uri, căuta produse, completa câmpuri și executa anumite acțiuni în numele utilizatorului.

Aici apare diferența dintre un AI care îți spune ce să cumperi și unul care poate face pașii necesari pentru cumpărare.

Cum ar putea arăta o cumpărătură făcută de AI?

Să presupunem că vrei să cumperi un monitor.

În loc să cauți manual zeci de produse, ai putea să îi dai AI-ului câteva reguli:

  • buget maxim: 1.500 lei;
  • diagonală: minimum 27″;
  • rezoluție: QHD;
  • utilizare: office și multimedia;
  • să fie disponibil în stoc;
  • livrare în România.

Un agent AI ar putea, în funcție de accesul pe care îl are, să caute magazine, să compare produsele și să elimine variantele care nu respectă criteriile.

Apoi ar putea ajunge la pagina produsului, să îl adauge în coș și să pregătească achiziția.

Într-un sistem configurat pentru acțiuni reale, ultimii pași pot include chiar completarea datelor necesare și plasarea comenzii.

Dar aici apare cea mai importantă întrebare:

Cine decide dacă produsul este într-adevăr cel potrivit?

Problema nu este doar „poate AI-ul?”

Tehnic, capacitatea de a naviga pe un site și de a completa un formular este doar o parte a problemei.

O cumpărătură implică și decizii.

De exemplu, două laptopuri pot avea același preț și aceeași cantitate de RAM, dar unul poate avea un ecran mai bun, o baterie mai mare sau o construcție diferită.

AI-ul poate compara specificațiile, dar trebuie să știe și ce contează pentru tine.

Cu cât îi dai mai multe reguli, cu atât poate lua decizii mai apropiate de ceea ce îți dorești.

„Cumpără-mi un laptop.”

este o instrucțiune foarte vagă.

În schimb:

„Cumpără-mi un laptop de maximum 3.500 lei, minimum 16 GB RAM, SSD de minimum 512 GB, Windows 11 Pro, cu ecran de minimum 15 inch, dar nu cumpăra nimic fără să îmi arăți înainte produsul și prețul.”

este mult mai clară.

AI-ul poate pune produsul în coș fără să cumpere?

Da, iar acesta poate fi un compromis foarte util.

În loc să îi dai AI-ului permisiunea de a finaliza automat orice comandă, îl poți lăsa să facă partea de cercetare și pregătire.

De exemplu:

AI caută → compară → verifică → adaugă în coș → tu aprobi → comanda este finalizată.

Astfel, AI-ul preia partea repetitivă, dar decizia finală rămâne la utilizator.

Pentru produse mai scumpe, această abordare este mult mai ușor de controlat.

Dar poate AI-ul să introducă datele cardului?

Aici lucrurile devin mult mai sensibile.

Pentru ca un AI să finalizeze o cumpărătură, poate avea nevoie de acces la informații personale, adresă de livrare, conturi de utilizator sau metode de plată.

Asta înseamnă că problema nu mai este doar tehnică.

Devine una de securitate și permisiuni.

Cu cât AI-ul are mai mult acces, cu atât poate face mai multe lucruri în locul tău. Dar, în același timp, o eroare a sistemului poate avea consecințe mai serioase.

Dacă un AI greșește o recomandare, cel mai rău lucru poate fi să îți arate un produs nepotrivit.

Dacă are permisiunea să cumpere automat, aceeași greșeală poate ajunge direct într-o comandă reală.

Ce se întâmplă dacă AI-ul alege produsul greșit?

Să presupunem că îi ceri:

„Cumpără cel mai ieftin SSD de 2 TB disponibil.”

AI-ul găsește un produs care pare să respecte cerința.

Dar „cel mai ieftin” nu înseamnă neapărat „cea mai bună alegere”.

Poate fi vorba despre:

  • un model cu performanță mai slabă;
  • un produs fără stoc real;
  • o capacitate interpretată greșit;
  • un magazin cu condiții de livrare diferite;
  • un produs compatibil doar cu anumite dispozitive;
  • o ofertă care nu mai este valabilă.

De aceea, un AI care cumpără în numele tău trebuie să aibă reguli foarte clare și, ideal, limite pentru acțiunile pe care le poate executa singur.

Ar putea AI-ul să facă singur cumpărăturile repetitive?

Aici conceptul devine și mai interesant.

Imaginează-ți că o firmă consumă constant anumite produse:

  • hârtie pentru imprimante;
  • toner;
  • etichete;
  • cabluri;
  • periferice;
  • consumabile.

În loc ca cineva să verifice în fiecare săptămână stocurile și să plaseze comenzile, un sistem automatizat ar putea identifica momentul în care anumite produse trebuie comandate și să pregătească achiziția.

În funcție de integrarea disponibilă, AI-ul ar putea chiar să execute pașii automat.

Acesta este unul dintre motivele pentru care agenții AI sunt interesanți în zona de business: nu doar răspund la întrebări, ci pot transforma anumite procese repetitive în fluxuri automate.

AI-ul nu trebuie să aibă acces la tot

Unul dintre cele mai importante principii este accesul minim necesar.

Dacă AI-ul trebuie doar să caute produse, nu are nevoie de acces la card.

Dacă trebuie să compare prețuri, nu are nevoie de parola contului tău.

Dacă trebuie să pregătească un coș, nu înseamnă automat că trebuie să poată finaliza comanda.

Un sistem bine configurat poate împărți procesul în mai multe etape și poate cere aprobarea utilizatorului înainte de acțiunile importante.

Este aceeași idee pe care o întâlnim și în alte scenarii cu agenți AI: cu cât îi dai mai multe permisiuni, cu atât trebuie să fii mai atent la ce poate face în numele tău.

Va ajunge AI-ul să facă singur cumpărăturile?

Probabil că vom vedea din ce în ce mai multe scenarii în care AI-ul nu doar caută produse, ci execută efectiv acțiuni pe site-uri.

Dar asta nu înseamnă că utilizatorul trebuie să îi ofere automat acces complet.

Pentru cumpărături, o variantă foarte practică este ca AI-ul să se ocupe de partea consumatoare de timp:

caută → compară → verifică → recomandă → pregătește comanda.

Iar utilizatorul să păstreze controlul asupra acțiunii finale.

Pe măsură ce agenții AI devin mai capabili să navigheze pe internet și să interacționeze cu aplicații, diferența dintre „îți găsesc un produs” și „îți cumpăr produsul” devine din ce în ce mai mică.

Poate AI-ul să cumpere ceva online în locul tău? Da, în anumite configurații și cu accesul necesar, poate ajunge mult mai departe decât simpla recomandare.

Întrebarea importantă nu va fi însă doar cât de mult poate face AI-ul, ci cât de mult vrei să îi permiți să facă fără să te întrebe.

Jev, un model AI diferit de LLM-urile tradiționale

Timp de citit: 5 minutes

Un nou tip de model de inteligență artificială încearcă să schimbe modul în care software-ul folosește AI-ul. Jev, dezvoltat de TypeSafe AI, nu este un Large Language Model (LLM) clasic și nu este conceput pentru conversații. În schimb, modelul produce decizii structurate, însoțite de probabilități și estimări de încredere, cu scopul de a face automatizarea software mai rapidă, mai ieftină și mai predictibilă.

Ideea a atras rapid atenția dezvoltatorilor, iar apariția lui Jev marchează o posibilă schimbare de direcție în dezvoltarea aplicațiilor bazate pe inteligență artificială. Informațiile au fost prezentate de TechCrunch pe 18 septembrie 2026, într-un articol dedicat proiectului TypeSafe și lui Diogo Almeida, cercetător care a lucrat anterior la OpenAI.

Ce este Jev și de ce este diferit de un chatbot AI?

Majoritatea modelelor AI populare sunt construite pentru a genera text. ChatGPT, Claude, Gemini și alte modele lingvistice primesc informații și produc secvențe de text, ceea ce le face extrem de flexibile pentru conversații, programare, redactare și analiză.

Jev abordează problema diferit.

Modelul dezvoltat de TypeSafe AI este conceput pentru decizii structurate pe care software-ul le poate utiliza direct. În loc să genereze un răspuns textual care trebuie ulterior interpretat și validat de un program, Jev returnează valori de tip structurat și probabilități asociate deciziilor. TypeSafe numește această categorie de modele AI „System One Models”.

Conceptul este important pentru automatizare. Dacă o aplicație trebuie să decidă dacă un mesaj este spam, dacă o tranzacție necesită verificare umană sau dacă un incident de securitate trebuie escaladat, nu are întotdeauna nevoie de un paragraf generat de AI. Are nevoie de o decizie clară.

De ce a creat TypeSafe un model AI care nu generează text?

Potrivit lui Diogo Almeida, fondatorul TypeSafe, problema este legată de diferența dintre ceea ce este optimizat pentru oameni și ceea ce este util pentru computere.

Almeida a lucrat anterior la OpenAI și este asociat cu dezvoltarea unor metode precum Reinforcement Learning from Human Feedback (RLHF), utilizate pentru îmbunătățirea comportamentului modelelor lingvistice. În viziunea sa, modelele au devenit foarte bune la limbaj, însă limbajul natural nu este întotdeauna interfața ideală pentru software.

TypeSafe încearcă astfel să construiască un model AI destinat în primul rând utilizării de către alte programe.

Compania spune că Jev folosește o arhitectură nouă, un mecanism de eșantionare paralelă și o metodă de antrenare numită Reinforcement Learning for Calibrated Decisions (RLCD). În loc să optimizeze generarea unor răspunsuri preferate de oameni, obiectivul este obținerea unor decizii structurate și a unor probabilități calibrate.

Cum poate Jev să reducă problema halucinațiilor AI?

Unul dintre argumentele centrale ale TypeSafe este că Jev nu generează text. Într-un LLM tradițional, modelul poate produce o afirmație incorectă, un cod greșit sau o informație inventată. Software-ul trebuie să interpreteze răspunsul și să verifice dacă acesta respectă formatul așteptat.

În cazul Jev, rezultatele sunt definite în avans. Modelul poate selecta, de exemplu, una dintre mai multe opțiuni sau poate furniza o probabilitate pentru o anumită decizie.

TypeSafe susține că această abordare elimină erorile de tip (type errors) deoarece structura rezultatului este definită înainte ca modelul să producă decizia. Compania afirmă, de asemenea, că fiecare rezultat este însoțit de o estimare a încrederii.

Este însă importantă o distincție: faptul că modelul produce rezultate structurate nu înseamnă că toate deciziile sale sunt automat corecte. Utilizatorii trebuie să stabilească praguri pentru automatizare și situațiile în care o decizie trebuie trimisă spre verificare umană.

Jev este mai rapid decât modelele AI tradiționale?

Viteza este una dintre principalele promisiuni ale TypeSafe. Compania spune că Jev poate răspunde în aproximativ 70-500 de milisecunde, în funcție de sarcină, și că abordarea sa poate fi de ordinul zecilor sau sutelor de ori mai rapidă în anumite scenarii de automatizare. Aceste valori sunt afirmații ale TypeSafe și trebuie interpretate în contextul testelor și workflow-urilor prezentate de companie, nu ca o regulă universală pentru toate aplicațiile AI.

Publicația TechCrunch relatează exemple concrete oferite de dezvoltatori. Un inginer software de la Vercel a afirmat că, într-un clasificator pentru verificarea siguranței comenzilor, trecerea de la un model OpenAI la Jev a dus la rezultate de 5 până la 18 ori mai rapide și la o acuratețe mai mare în testul respectiv. Un alt dezvoltator a comparat Jev cu Gemini pentru clasificarea e-mailurilor comerciale și a raportat un compromis între acuratețe, cost și disponibilitatea scorurilor de încredere.

Acestea sunt rezultate din teste specifice, nu benchmark-uri independente care demonstrează superioritatea generală a modelului.

Cât costă Jev?

Costul redus este o altă componentă importantă a strategiei TypeSafe. Pe pagina oficială a produsului, compania indică un preț de 42 de dolari pentru un miliard de tokeni de intrare, iar tokenii de ieșire sunt prezentați ca fiind gratuiti. TypeSafe susține că arhitectura este mult mai eficientă pentru sarcini de decizie decât modelele lingvistice tradiționale.

Pentru aplicațiile care procesează volume foarte mari de date, diferența de cost poate deveni relevantă.

De exemplu, un sistem care clasifică milioane de documente, verifică permanent fluxuri de date sau monitorizează agenți AI ar putea avea nevoie de milioane sau miliarde de evaluări. În astfel de situații, fiecare reducere a costului per operațiune poate schimba fezabilitatea economică a unui produs.

Pentru ce poate fi folosit Jev?

Jev nu încearcă să înlocuiască toate utilizările unui chatbot. Cazurile de utilizare prezentate de TypeSafe sunt concentrate pe automatizare și decizii în interiorul software-ului.

Printre exemple se află:

  • clasificarea automată a documentelor și mesajelor;
  • procesarea facturilor;
  • detectarea și prioritizarea incidentelor de securitate;
  • monitorizarea agenților AI;
  • detectarea tentativelor de jailbreak;
  • rutarea cererilor către modelul AI potrivit;
  • evaluarea riscului;
  • sisteme de scoring;
  • fluxuri software care trebuie să aleagă între mai multe acțiuni;
  • aplicații în timp real unde latența este critică.

TypeSafe prezintă inclusiv workflow-uri pentru incidente de securitate, procesarea facturilor, servicii pentru clienți și observabilitatea agenților AI.

Jev poate lucra împreună cu alte modele tip LLM

Una dintre ideile interesante este că Jev nu trebuie neapărat să înlocuiască modelele lingvistice. Modelul poate fi folosit ca un strat de verificare pentru alți agenți AI. De exemplu, un LLM poate genera un răspuns sau executa o serie de acțiuni, iar Jev poate analiza rezultatul și decide dacă acesta trebuie acceptat, respins sau trimis către un operator uman.

Această arhitectură poate fi relevantă pe măsură ce aplicațiile folosesc tot mai mulți agenți AI autonomi. În loc ca fiecare agent să fie verificat manual, un model specializat în decizii poate funcționa ca un filtru automat.

Ce înseamnă “System One Model”?

Denumirea vine din distincția popularizată de psihologul Daniel Kahneman între gândirea rapidă și intuitivă și gândirea lentă, deliberativă.

TypeSafe folosește conceptul pentru a descrie modele concentrate pe decizii rapide și structurate, spre deosebire de modelele concepute pentru raționament extins și generare de limbaj.

Jev este primul model public din această categorie dezvoltat de TypeSafe și se află, în prezent, în early access.

Ce trebuie urmărit înainte de a considera Jev o alternativă la LLM?

Cea mai importantă întrebare este dacă modelele specializate pot transforma promisiunile de eficiență în rezultate consistente în producție.

TypeSafe publică propriile evaluări și explică metodologia utilizată. Compania avertizează inclusiv asupra limitărilor evaluărilor și susține că benchmark-urile publice pot crea stimulente pentru optimizarea artificială a rezultatelor.

Prin urmare, afirmații precum „193,6x mai rapid” sau „444,6x mai ieftin” trebuie citite ca rezultate raportate de TypeSafe pentru anumite metode de lucru, nu ca o caracteristică universală a Jev în orice aplicație. Site-ul companiei prezintă aceste valori în contextul unor teste proprii.

Pentru dezvoltatori, testarea pe propriile date și propriile fluxuri de lucru rămâne esențială.

De ce acest model este important pentru viitorul inteligenței artificiale?

Jev ilustrează o idee mai largă: viitorul AI nu trebuie să fie format exclusiv din modele care dialoghează cu oamenii.

În anumite aplicații, limbajul natural poate fi o interfață inutil de costisitoare. Dacă un program are nevoie doar de răspunsul „aprobat”, „respins”, „dezvoltă” sau de o distribuție de probabilități, generarea unui paragraf întreg poate fi o etapă intermediară inutilă.

Modelul TypeSafe încearcă să mute inteligența artificială mai aproape de cod și de logica aplicațiilor: datele intră, modelul evaluează situația, iar software-ul primește o decizie structurată.

Această abordare ar putea deveni relevantă în automatizarea enterprise, cybersecurity, procesarea documentelor, agenți AI și aplicații cu cerințe stricte de latență.

Pentru moment, Jev este un produs aflat la început de drum și disponibil în early access. Însă apariția sa evidențiază o direcție importantă în industria AI: nu orice problemă are nevoie de un chatbot, iar unele dintre cele mai utile modele AI pentru software ar putea fi cele care nu generează deloc text.

Surse: typesafe.ai, techcrunch.com

PRODUSE RECOMANDATE

Poate AI-ul să lucreze singur pe calculatorul tău?

Timp de citit: 5 minutes

Până nu demult, când spuneai că folosești AI pe calculator, probabil te gândeai la un chatbot căruia îi scrii o întrebare și primești un răspuns.

Astăzi, lucrurile au început să se schimbe.

Unele sisteme AI pot să facă mai mult decât să genereze text sau să răspundă la întrebări. Pot analiza informații, utiliza aplicații, naviga pe site-uri, completa formulare, organiza fișiere și executa o serie de acțiuni în locul utilizatorului.

De aici apare o întrebare interesantă: poate AI-ul să lucreze singur pe calculatorul tău?

Răspunsul scurt este: da, în anumite condiții. Dar nu înseamnă că orice AI poate prelua controlul calculatorului și poate face absolut orice dorește.

De la chatbot la AI Agent

Un chatbot obișnuit funcționează relativ simplu.

Îi scrii:

„Scrie-mi un e-mail pentru un client.”

AI-ul generează textul, iar tu îl copiezi și îl trimiți.

Un AI Agent poate avea însă un rol mult mai activ.

Îi poți da o sarcină mai complexă, iar sistemul poate încerca să parcurgă singur mai mulți pași pentru a ajunge la rezultat.

De exemplu:

„Găsește cele mai bune oferte pentru un laptop cu 16 GB RAM și fă-mi un tabel cu prețurile.”

În funcție de instrumentul folosit și de permisiunile pe care le are, AI-ul poate căuta informațiile, deschide pagini, extrage datele și organiza rezultatele.

Diferența este importantă: AI-ul nu mai este doar un instrument care îți spune ce să faci, ci poate deveni un instrument care execută o parte din ceea ce i-ai cerut.

Cum poate AI-ul să „vadă” calculatorul?

Pentru ca un AI să lucreze efectiv pe calculator, trebuie să aibă acces la anumite elemente ale sistemului.

Acest acces poate fi oferit prin:

  • un browser controlat de AI;
  • aplicații special concepute pentru agenți AI;
  • API-uri;
  • integrări cu alte programe;
  • instrumente care permit interacțiunea cu interfața grafică;
  • acces controlat la fișiere și foldere.

În unele situații, AI-ul poate primi o imagine a ecranului și poate identifica butoane, meniuri sau câmpuri.

Apoi poate decide care este următoarea acțiune și poate executa acel pas.

Practic, în loc să îi explici:

„Apasă aici, apoi deschide meniul acesta și completează câmpul respectiv”

poți să îi dai obiectivul, iar sistemul poate încerca să găsească singur pașii necesari.

Poate AI-ul să deschidă programe?

În anumite configurații, da.

Un agent AI poate fi conectat la aplicații sau la un mediu de lucru în care are permisiunea să execute acțiuni.

De exemplu, poate putea:

  • deschide un browser;
  • naviga pe anumite site-uri;
  • completa câmpuri;
  • lucra cu documente;
  • analiza fișiere;
  • organiza informații;
  • genera rapoarte;
  • muta sau redenumi anumite fișiere;
  • interacționa cu aplicații compatibile.

Dar aici apare un detaliu foarte important: accesul AI-ului este limitat de instrumentele și permisiunile pe care le primește.

Un chatbot care nu are acces la calculator nu poate pur și simplu să înceapă să îți controleze PC-ul.

AI-ul poate folosi mouse-ul și tastatura?

În anumite sisteme, acesta este chiar principiul de funcționare.

AI-ul poate primi imaginea ecranului, poate identifica elementele relevante și poate efectua acțiuni precum clicuri sau introducerea de text.

Este o evoluție importantă deoarece permite AI-ului să lucreze cu aplicații care nu au neapărat o integrare directă.

De exemplu, dacă un program are o interfață grafică obișnuită, agentul poate interacționa cu ea într-un mod asemănător unui utilizator.

Totuși, asta nu înseamnă că AI-ul „înțelege” calculatorul exact ca un om. El interpretează informațiile disponibile și încearcă să execute acțiunile necesare pe baza obiectivului primit.

Poate să lucreze fără să îl supraveghezi?

Uneori, da.

Unele sisteme sunt concepute pentru a executa mai mulți pași consecutivi fără să ceară confirmare după fiecare acțiune.

De exemplu, dacă îi ceri să colecteze informații de pe mai multe site-uri și să le organizeze într-un document, poate efectua o parte din proces automat.

Dar cu cât îi oferi mai multe permisiuni, cu atât devine mai important controlul asupra acțiunilor sale.

Este una dintre diferențele importante dintre un chatbot și un agent AI.

Un chatbot poate genera un răspuns greșit.

Un agent AI care are acces la aplicații poate, în anumite situații, să execute o acțiune greșită.

Ce se întâmplă dacă AI-ul face o greșeală?

Aici apare una dintre cele mai importante limite ale agenților AI.

AI-ul poate interpreta greșit o informație sau poate lua o decizie greșită.

Dacă doar îți oferă un răspuns greșit, poți să îl ignori.

Dacă are acces la calculator și execută acțiuni, consecințele pot fi mai serioase.

De exemplu, un agent ar putea:

  • completa greșit un formular;
  • selecta un produs greșit;
  • modifica un document;
  • muta un fișier în locul nepotrivit;
  • introduce o informație greșită;
  • naviga către o pagină neașteptată.

Din acest motiv, sistemele serioase de automatizare folosesc diferite niveluri de permisiuni și pot solicita confirmarea utilizatorului înaintea acțiunilor importante.

Poate AI-ul să șteargă fișiere?

Aici răspunsul depinde în totalitate de accesul pe care îl are.

Un AI fără acces la sistemul tău de fișiere nu poate șterge fișiere de pe calculator doar pentru că îi ceri asta.

Un agent care are permisiuni asupra anumitor foldere poate însă efectua operațiuni asupra fișierelor respective.

Tocmai de aceea este important să nu oferi unui agent mai multe permisiuni decât are nevoie.

Dacă un AI trebuie să analizeze un folder cu documente, nu înseamnă automat că ar trebui să aibă acces la întregul calculator.

Poate AI-ul să instaleze programe?

În anumite configurații, poate iniția sau efectua instalări dacă are acces suficient și dacă mediul permite acest lucru.

Dar instalarea unui program este o acțiune care poate modifica sistemul și poate introduce riscuri.

De aceea, pentru operațiuni importante este mai sigur ca utilizatorul să aibă ultimul cuvânt.

Un AI poate găsi un program, poate explica pașii de instalare sau poate pregăti procesul, fără ca instalarea să fie făcută automat fără verificare.

AI-ul poate lucra și când nu ești la calculator?

În anumite scenarii, da.

Agenții AI pot fi integrați în fluxuri automatizate care rulează la anumite intervale sau ca răspuns la anumite evenimente.

De exemplu, un sistem poate fi configurat să:

  1. primească date;
  2. le analizeze;
  3. genereze un raport;
  4. salveze raportul;
  5. trimită o notificare.

În acest caz, utilizatorul nu trebuie să stea în fața calculatorului pentru fiecare pas.

Totuși, aceasta este mai degrabă o automatizare controlată decât ideea că AI-ul „s-a trezit singur și a început să lucreze”.

Agentul are nevoie de reguli, acces și un mediu în care să poată executa acele acțiuni.

Este sigur să îi dai AI-ului acces la calculator?

Depinde foarte mult de ce acces îi oferi.

Regula simplă este:

cu cât AI-ul poate face mai multe lucruri, cu atât trebuie să fii mai atent la permisiuni.

Dacă un agent are acces doar la un folder de lucru, riscul este diferit față de situația în care are acces la întregul sistem.

Pentru activități importante, este recomandat să:

  • limitezi accesul la ceea ce este necesar;
  • eviți să îi oferi privilegii de administrator fără motiv;
  • nu îi dai acces inutil la parole;
  • nu îl lași să execute automat acțiuni ireversibile;
  • verifici acțiunile importante înainte de confirmare;
  • păstrezi backup pentru date importante.

Poate AI-ul să înlocuiască utilizatorul?

Nu complet.

Chiar dacă agenții AI pot executa din ce în ce mai multe operațiuni, oamenii rămân importanți pentru stabilirea obiectivelor, verificarea rezultatelor și gestionarea situațiilor neprevăzute.

Imaginează-ți un angajat virtual foarte rapid care poate face zeci de pași într-un timp scurt, dar care poate interpreta greșit o instrucțiune.

Cu cât sarcina este mai importantă, cu atât verificarea rezultatului devine mai valoroasă.

Pentru activități repetitive și bine definite, automatizarea poate fi foarte utilă. Pentru decizii sensibile sau acțiuni ireversibile, intervenția umană rămâne importantă.

Unde putem vedea deja această tehnologie?

Conceptul este deja prezent în mai multe domenii.

Agenții AI pot fi folosiți pentru:

  • cercetare și colectare de informații;
  • automatizarea sarcinilor repetitive;
  • procesarea documentelor;
  • analiza datelor;
  • suport pentru clienți;
  • gestionarea unor fluxuri administrative;
  • programare;
  • testarea aplicațiilor;
  • automatizarea unor operațiuni în browser.

Pe măsură ce aceste sisteme devin mai bune la utilizarea interfețelor grafice și la executarea mai multor pași consecutivi, diferența dintre „AI care îți răspunde” și „AI care lucrează pentru tine” devine din ce în ce mai mică.

Concluzie

Poate AI-ul să lucreze singur pe calculatorul tău? Da, în anumite condiții.

Dar nu trebuie să ne imaginăm că orice chatbot poate prelua instantaneu controlul unui PC.

Pentru ca un AI să poată lucra efectiv pe calculator, trebuie să primească acces la instrumentele, aplicațiile, fișierele sau mediul de lucru necesar.

Iar aici apare cea mai importantă regulă: nu îi oferi mai multe permisiuni decât are nevoie.

AI-ul poate deveni foarte bun la executarea unor sarcini repetitive și complexe, însă poate face și greșeli. Diferența dintre un răspuns greșit și o acțiune greșită este importantă.

Viitorul nu înseamnă neapărat un AI care îți controlează calculatorul în locul tău. Mai degrabă, înseamnă calculatoare în care AI-ul poate prelua tot mai multe sarcini, iar utilizatorul stabilește ce are voie să facă și verifică rezultatul.

AI-ul nu trebuie să înlocuiască omul pentru a fi util. Uneori este suficient să preia toate acele lucruri repetitive pe care nimeni nu are chef să le facă.

De ce agenții AI nu pot securiza (încă) alți agenți AI

Timp de citit: 5 minutes

Inteligența artificială trece rapid de la etapa în care genera texte, imagini sau răspunsuri la întrebări către agenți AI capabili să acționeze autonom în mediile digitale ale organizațiilor și companiilor.

Agenții AI pot utiliza instrumente software, pot apela API-uri, pot accesa informații interne și, în anumite configurații, pot modifica date sau executa acțiuni în sisteme de business. Această evoluție transformă radical modul în care companiile trebuie să abordeze securitatea cibernetică.

În acest context apare o idee aparent logică: dacă numărul agenților AI crește, de ce să nu folosim alți agenți AI pentru a-i monitoriza și securiza?

Problema este că această strategie poate introduce un nou nivel de complexitate și poate chiar extinde suprafața de atac, în loc să o reducă.

De ce utilizarea de agenți AI pentru securitate este problematică

Una dintre principalele probleme este natura probabilistică a modelelor lingvistice mari (LLM).

Un sistem AI generează rezultate pe baza unor probabilități și tipare învățate. În schimb, controalele de securitate critice trebuie, în multe situații, să ofere rezultate predictibile și repetabile.

Diferența este esențială.

Un agent AI poate interpreta greșit o situație și poate considera sigură o acțiune care nu ar trebui permisă. Invers, poate bloca o operațiune legitimă și importantă pentru companie.

Într-un scenariu cu risc ridicat, o decizie greșită poate însemna ștergerea unor date, modificarea unor resurse digitale, accesarea unor informații confidențiale sau întreruperea unui proces operațional.

De aceea, un model probabilistic nu ar trebui să fie singurul mecanism care definește o graniță de securitate deterministă.

Asta nu înseamnă că inteligența artificială nu are un rol important în securitatea cibernetică. Dimpotrivă, poate fi extrem de utilă pentru identificarea unor comportamente neobișnuite, investigarea alertelor și analizarea unor situații complexe pe care regulile statice le pot rata.

Diferența constă în rolul pe care îl primește AI-ul.

Agenții AI care securizează agenți AI

O altă problemă este proliferarea agenților AI. Pe măsură ce organizațiile implementează tot mai mulți agenți, tentația naturală este să adauge alte sisteme AI pentru monitorizare, verificare și remediere.

Acest model poate genera o proliferare greu de controlat a agenților, permisiunilor, integrărilor și mecanismelor de monitorizare.

Fiecare agent AI suplimentar poate avea:

  • propriile permisiuni;
  • propriile conexiuni la API-uri;
  • acces la anumite date;
  • propriul context;
  • costuri de procesare;
  • latență suplimentară;
  • noi puncte care trebuie monitorizate și securizate.

În loc să simplifice arhitectura de securitate, o rețea formată din agenți care monitorizează alți agenți poate face sistemul mai greu de înțeles.

Mai mult, atunci când un agent defensiv interpretează acțiunile unui alt agent, echipa de securitate trebuie să poată determina de ce a fost luată fiecare decizie și care control a permis sau a blocat acțiunea.

Această trasabilitate este esențială pentru audit, incident response și conformitate.

Cum pot fi securizați agenții AI?

Înainte ca o companie să poată controla agenții AI, trebuie să știe unde sunt aceștia și ce fac. Inventarierea agenților autorizați reprezintă un punct de pornire, dar nu este suficientă.

În organizații pot apărea agenți adoptați de angajați sau de departamente fără implicarea directă a echipei centrale de IT. Pot exista, de asemenea, funcții AI integrate în aplicații SaaS și alte servicii care nu sunt percepute imediat ca „agenți AI”.

Acest fenomen este asociat frecvent cu termenul shadow AI.

Interzicerea totală a acestor instrumente nu este neapărat o soluție eficientă. În unele cazuri, utilizatorii pot continua să le folosească în afara proceselor oficiale de guvernanță.

O strategie mai solidă presupune identificarea și clasificarea agenților în funcție de risc.

De exemplu, prioritatea ar trebui acordată agenților AI care:

  • procesează informații sensibile;
  • au acces la sisteme interne;
  • pot modifica sau șterge date;
  • pot comunica extern;
  • pot iniția tranzacții financiare;
  • pot modifica sisteme critice.

Identitatea și principiul „least privilege” devin esențiale

Fiecare agent AI ar trebui să aibă o identitate verificabilă, un proprietar clar și un set de permisiuni strict delimitat.

Principiul „least privilege”, acordarea nivelului minim de acces necesar pentru îndeplinirea unei sarcini, devine și mai important într-un ecosistem cu agenți autonomi.

Un agent care trebuie doar să consulte un profil de client nu ar trebui să poată modifica acel profil.

La fel, un agent care are nevoie de acces la un anumit cont sau set de date nu ar trebui să primească automat acces la întreaga bază de date.

Această separare poate limita impactul unei erori, al unei configurații greșite sau al unei tentative de manipulare a agentului.

API-urile și MCP trebuie controlate la nivel de execuție

Pe măsură ce agenții AI interacționează cu instrumente, API-uri și standarde precum Model Context Protocol (MCP), securitatea nu se mai poate concentra exclusiv pe prompturi.

Filtrarea prompturilor poate identifica anumite instrucțiuni suspecte, dar nu poate răspunde singură la întrebarea fundamentală:

Au agentii AI dreptul să execute această acțiune?

Răspunsul trebuie să fie susținut de controale de runtime. Organizațiile pot utiliza liste de permisiuni, restricții asupra parametrilor, autorizare bazată pe identitate și verificări de politici înainte ca un agent să poată apela un instrument.

De exemplu, un agent poate avea permisiunea să citească datele unui client, dar nu să le modifice. Sau poate consulta doar datele asociate unui anumit identificator, nu întreaga bază de date.

Aceste mecanisme reduc posibilitatea ca o instrucțiune malițioasă sau o interacțiune neașteptată să determine extinderea privilegiilor agentului.

Nu toate acțiunile agenților AI trebuie tratate cu același nivel de risc

O greșeală frecventă în proiectarea securității AI este încercarea de a proteja toate interacțiunile în același mod. O abordare bazată pe risc este mai eficientă.

Organizațiile ar trebui să înceapă cu fluxurile care pot produce cele mai mari consecințe asupra afacerii: date sensibile, comunicări externe, tranzacții financiare și modificări ale sistemelor critice.

Pentru aceste zone pot fi implementate controale suplimentare, inclusiv:

  • reguli deterministe;
  • validarea parametrilor;
  • liste de permisiuni;
  • politici de autorizare;
  • controale împotriva prompt injection;
  • mecanisme de prevenire a pierderii datelor (DLP);
  • audit complet al acțiunilor;
  • backup-uri pentru sistemele accesibile agenților;
  • procese de aprobare umană pentru operațiuni critice.

Ce înseamnă acest lucru pentru companii?

Mesajul important pentru organizații nu este că AI nu poate fi folosit pentru securitate. Dimpotrivă, AI poate deveni un instrument valoros pentru echipele de securitate cibernetică, însă nu ar trebui confundat cu un înlocuitor universal pentru controalele deterministe.

Un model AI poate ajuta la prioritizarea alertelor, corelarea evenimentelor și investigarea unor comportamente complexe. Dar deciziile cu impact major trebuie să fie încadrate de politici și mecanisme tehnice verificabile.

Cu alte cuvinte, arhitectura de securitate ar trebui să pornească de la întrebarea:

„Ce are voie agentul să facă?”

și nu doar de la:

„Cum putem folosi AI pentru a monitoriza agentul?”

Această schimbare de perspectivă este esențială pentru dezvoltarea unei strategii de securitate AI fiabile.

Viitorul securității cibernetice bazat pe agenți AI

AI agentic poate aduce beneficii importante pentru automatizarea proceselor enterprise, însă autonomia suplimentară vine cu responsabilități suplimentare de securitate.

Folosirea unui agent AI pentru securizarea altui agent poate părea o soluție elegantă, dar introduce riscuri atunci când sistemele probabilistice primesc responsabilitatea de a impune controale care trebuie să fie predictibile.

O strategie mai robustă începe cu vizibilitate, identitate, controlul accesului și politici deterministe de runtime. Agenții trebuie inventariați, asociați unor proprietari și limitați la permisiunile strict necesare.

AI-ul poate completa aceste mecanisme prin analiză și detecție, dar nu ar trebui să fie singura linie de apărare.

Pentru organizațiile care adoptă AI agentic în 2026, regula de bază este simplă: cu cât un agent are mai multă autonomie și acces la sisteme critice, cu atât controalele de securitate trebuie să fie mai deterministe, mai verificabile și mai ușor de auditat.

Sursa: computerweekly.com

PRODUSE RECOMANDATE

Tokenurile Claude furate de hackeri? Ce raportează utilizatorii

Timp de citit: 5 minutes

Utilizatorii Claude raportează cazuri în care limitele de utilizare dispar rapid, chiar și atunci când nu folosesc activ serviciul. În unele situații, consumul ajunge de la câteva procente la 100% în mai puțin de o oră. Situația a atras atenția după ce TechCrunch a relatat despre cazuri în care tokenurile și sesiunile unor abonați Claude ar fi fost compromise și folosite fără autorizare.

Problema este importantă în special pentru utilizatorii planurilor plătite Claude, inclusiv cei care folosesc Claude Code, deoarece consumul neautorizat poate epuiza rapid limita disponibilă și, în anumite configurații, poate genera costuri suplimentare.

Utilizarea Claude poate crește fără ca utilizatorul să folosească serviciul

Un caz publicat pe Reddit, în comunitatea r/ClaudeAI, ilustrează foarte clar problema. Autorul postării spune că a descoperit două facturi Anthropic: una pentru un abonament Max 20x și alta asociată utilizării suplimentare. Pentru a verifica ce se întâmplă, acesta a urmărit pagina de Usage fără să folosească Claude.

Rezultatul a fost surprinzător: utilizarea sesiunii a crescut de la 11% la ora 11:09, la 47% la 11:20, pentru ca la 11:40 să ajungă la 100%.

Cu alte cuvinte, limita a fost consumată aproape complet în aproximativ 31 de minute, în condițiile în care autorul susține că nu folosea Claude în acel interval.

În același timp, în zona dedicată Claude Code era afișat mesajul „No Claude Code instance connected”, potrivit capturii și descrierii publicate în postare.

Un alt element îngrijorător: limita de cheltuieli

Autorul spune că funcția de utilizare suplimentară era dezactivată, însă a observat în setări o limită de cheltuieli de 2.000 de euro.

Acest detaliu este relevant pentru securitatea conturilor AI deoarece un utilizator poate porni de la un abonament fix, dar poate avea asociate mecanisme de utilizare suplimentară sau limite de cheltuieli.

În cazul unei sesiuni compromise, accesul neautorizat nu înseamnă doar consumarea limitei incluse în abonament. În funcție de configurația contului, poate exista și riscul unor costuri suplimentare.

Autorul postării spune că a contactat Anthropic prin chat și e-mail pentru a afla originea consumului și pentru a solicita ajutor.

Ce spun utilizatorii Reddit despre problema Claude?

Cazul nu pare izolat în comunitatea ClaudeAI. În aceeași discuție, mai mulți utilizatori au relatat situații în care limitele de utilizare au fost consumate mult mai rapid decât se așteptau. Unii afirmă că au văzut creșteri foarte rapide ale consumului, în timp ce alții spun că au întâlnit probleme chiar după ce au verificat sau revocat sesiunile.

Există însă o nuanță importantă: comentariile Reddit reprezintă relatări ale utilizatorilor și nu constituie, în sine, dovada unei breșe generale în infrastructura Anthropic.

În thread apar mai multe ipoteze: de la bug-uri de cont și probleme de calcul al utilizării până la sesiuni compromise sau utilizarea Claude Code în fundal. Unii utilizatori afirmă chiar că au rotit tokenurile și au închis sesiunile, dar au continuat să observe consum neobișnuit.

Prin urmare, este mai corect să vorbim despre rapoarte de consum inexplicabil și cazuri investigate pentru posibil acces neautorizat, nu despre o confirmare că toate conturile Claude au fost sparte.

Cum pot fi furate sesiunile și tokenurile Claude?

Potrivit relatării TechCrunch, Anthropic a identificat cazuri în care atacatorii au folosit infostealer malware pentru a fura informații de autentificare și sesiuni Claude de pe computerele utilizatorilor.

Un infostealer este un tip de malware specializat în colectarea informațiilor sensibile de pe un dispozitiv. Acestea pot include parole salvate, cookie-uri și date asociate sesiunilor autentificate.

Riscul este important. O sesiune deja autentificată poate permite unui atacator să evite barierele întâlnite în cazul unei tentative clasice de autentificare.

Într-un asemenea scenariu, utilizatorul poate să nu observe imediat o conectare suspectă. În schimb, primul semnal poate fi unul indirect: limita Claude se consumă fără o activitate corespunzătoare din partea utilizatorului.

Infrastructura Anthropic a fost compromisă?

Nu există suficiente informații pentru a spune că infrastructura Anthropic a fost compromisă la nivel general. Există cel puțin două scenarii care pot produce rezultate asemănătoare:

Primul scenariu: contul sau sesiunea utilizatorului este compromisă. Un atacator obține acces la o sesiune autentică și consumă resursele contului.

Al doilea scenariu: există o eroare software, o problemă de contabilizare a utilizării sau o activitate legitimă care nu este afișată clar utilizatorului.

Postările Reddit demonstrează că există utilizatori care observă consum neobișnuit, însă nu pot stabili singure cauza. Relatarea TechCrunch adaugă însă un element important: Anthropic a avertizat în unele cazuri despre utilizarea unor infostealere și despre compromiterea sesiunilor.

De aceea, utilizatorii care observă un consum inexplicabil ar trebui să trateze situația ca pe un posibil incident de securitate, până când cauza este clarificată.

PRODUSE RECOMANDATE

Ce trebuie să faci dacă Claude îți consumă tokenurile fără explicație?

Dacă observi că limita Claude scade în timp ce nu folosești serviciul, există câteva măsuri rezonabile.

1. Verifică imediat pagina Usage

Notează ora și procentul de utilizare.

Dacă procentul crește în timp ce nu trimiți prompturi, fă capturi de ecran. Acestea pot fi utile atunci când contactezi suportul.

2. Închide sesiunile active

Dacă există posibilitatea unei sesiuni compromise, invalidarea sesiunilor poate împiedica folosirea în continuare a accesului respectiv.

3. Revocă tokenurile Claude și cheile asociate

Utilizatorii Claude Code și cei care folosesc integrații sau automatizări ar trebui să verifice tokenurile și cheile de autentificare active.

4. Verifică dispozitivul pentru malware

Dacă suspectezi un infostealer, problema nu trebuie tratată doar la nivelul contului Claude.

Un malware care fură sesiuni poate viza și alte servicii utilizate pe același computer.

5. Verifică setările de utilizare suplimentară

Este important să verifici dacă ai activată utilizarea peste limita inclusă și care este plafonul de cheltuieli. În cazul relatat pe Reddit, autorul afirmă că a descoperit o limită de cheltuieli de 2.000 de euro, deși susținea că “extra usage” era dezactivat.

6. Contactează Anthropic

Dacă utilizarea continuă să crească fără explicație, contactează suportul Anthropic și oferă:

  • ora la care ai observat problema;
  • procentul inițial și procentul final;
  • capturi de ecran;
  • informații despre Claude Code și alte integrări;
  • eventualele facturi sau taxe suplimentare;
  • măsurile de securitate pe care le-ai aplicat deja.

De ce sunt tokenurile Claude o țintă pentru hackeri?

Tokenurile AI au devenit o resursă cu valoare economică. Un atacator care obține acces la un cont AI plătit poate utiliza infrastructura deja achiziționată de victimă. În cazul serviciilor cu limite generoase, aceasta poate însemna o cantitate semnificativă de procesare AI.

În plus, conturile Claude utilizate profesional pot fi conectate la instrumente de dezvoltare, proiecte software și alte servicii. Asta înseamnă că un cont AI nu mai trebuie privit doar ca un instrument pentru conversații.

Pentru un programator sau o companie, Claude poate deveni parte din infrastructura de lucru. Compromiterea unei sesiuni poate avea astfel consecințe mai importante decât simpla pierdere a câtorva mesaje.

Problema transparenței consumului

Unul dintre cele mai importante aspecte scoase la iveală de aceste cazuri este nevoia unei monitorizări mai detaliate a consumului AI.

Dacă un utilizator vede doar că limita a scăzut de la 10% la 100%, dar nu poate identifica exact ce activitate a generat consumul, investigarea unui incident devine dificilă.

Pentru serviciile AI cu abonamente și limite de utilizare, jurnalele detaliate de activitate ar putea deveni o componentă importantă de securitate.

Utilizatorul ar trebui să poată identifica, pe cât posibil:

  • când a fost consumată resursa;
  • ce tip de serviciu a generat consumul;
  • ce sesiune a fost implicată;
  • dacă utilizarea provine din Claude Web, Claude Code sau altă integrare;
  • dacă au existat activități neobișnuite.

Fără aceste informații, diferența dintre o eroare de facturare, consum legitim și un cont compromis poate fi dificil de stabilit.

Ce înseamnă incidentul pentru utilizatorii Claude?

Pentru utilizatorii obișnuiți, principala concluzie este simplă: monitorizarea consumului AI trebuie tratată și ca o măsură de securitate, nu doar ca o problemă de facturare.

Dacă limita Claude crește rapid fără ca utilizatorul să folosească serviciul, situația nu trebuie ignorată.

Postarea Reddit analizată aici oferă un exemplu concret: utilizarea a crescut de la 11% la 100% în aproximativ jumătate de oră, în timp ce autorul afirma că nu utiliza Claude.

În paralel, relatările despre sesiuni compromise și infostealere arată că utilizatorii trebuie să acorde atenție și securității dispozitivului de pe care accesează serviciile AI.

Consumul inexplicabil de tokenurile Claude trebuie investigat

Cazurile raportate în comunitatea Claude indică o problemă pe care utilizatorii serviciilor AI nu ar trebui să o trateze superficial.

Este important, însă, să evităm concluziile exagerate. Un consum anormal nu demonstrează automat că un cont a fost spart. Poate exista și o eroare de sistem, o problemă de contabilizare sau o activitate care nu este evidentă pentru utilizator.

Existența cazurilor în care sesiunile de autentificare au fost compromise arată de ce securitatea conturilor AI devine din ce în ce mai importantă. Pe măsură ce Claude Code și alți agenți AI sunt integrați în fluxurile profesionale, tokenurile, sesiunile și cheile de autentificare trebuie protejate la fel de atent ca parolele și API key-urile tradiționale.

Surse: techcrunch.com, reddit.com

PRODUSE RECOMANDATE

GPT-6 Astra: modelul OpenAI care schimbă regulile jocului

Timp de citit: 4 minutes

OpenAI a lansat GPT-6 Astra, cel mai avansat model de inteligență artificială al companiei până în prezent. Anunțat pe 3 septembrie 2026, GPT-6 Astra este conceput pentru sarcini complexe care combină raționamentul, programarea, cercetarea, utilizarea computerului și executarea unor fluxuri de lucru cu mai mulți pași.

Lansarea GPT-6 Astra marchează o schimbare importantă în evoluția modelelor AI: accentul nu mai este pus doar pe generarea de text sau răspunsuri conversaționale, ci pe capacitatea AI de a înțelege un obiectiv, de a utiliza instrumente și de a duce la capăt o activitate complexă.

Ce este GPT-6 Astra?

GPT-6 Astra este noul model de vârf dezvoltat de OpenAI pentru activități care necesită raționament avansat și execuție autonomă. Potrivit OpenAI, modelul este optimizat pentru utilizarea computerului, navigarea pe internet, software engineering, cybersecurity, cercetare științifică și activități profesionale.

Spre deosebire de modelele AI utilizate în principal pentru conversații, Astra este proiectat să lucreze cu aplicații și instrumente digitale. Poate, de exemplu, să completeze formulare online, să actualizeze informații într-un CRM, să organizeze un calendar, să efectueze cercetări online sau să analizeze date.

Această capacitate apropie noul model de conceptul de agent AI: utilizatorul oferă un obiectiv, iar modelul poate executa o serie de acțiuni pentru a ajunge la rezultatul dorit.

GPT-6 Astra: principalele noutăți

Una dintre cele mai importante îmbunătățiri este abilitatea modelului de a interacționa cu un computer și cu interfețe software. OpenAI afirmă că Astra poate efectua activități precum:

  • completarea formularelor online;
  • actualizarea bazelor de date și a sistemelor CRM;
  • cercetare pe internet;
  • analizarea datelor;
  • generarea de documente, prezentări și foi de calcul;
  • dezvoltarea și testarea unor aplicații;
  • depanarea problemelor software;
  • efectuarea unor fluxuri de lucru complexe cu mai mulți pași.

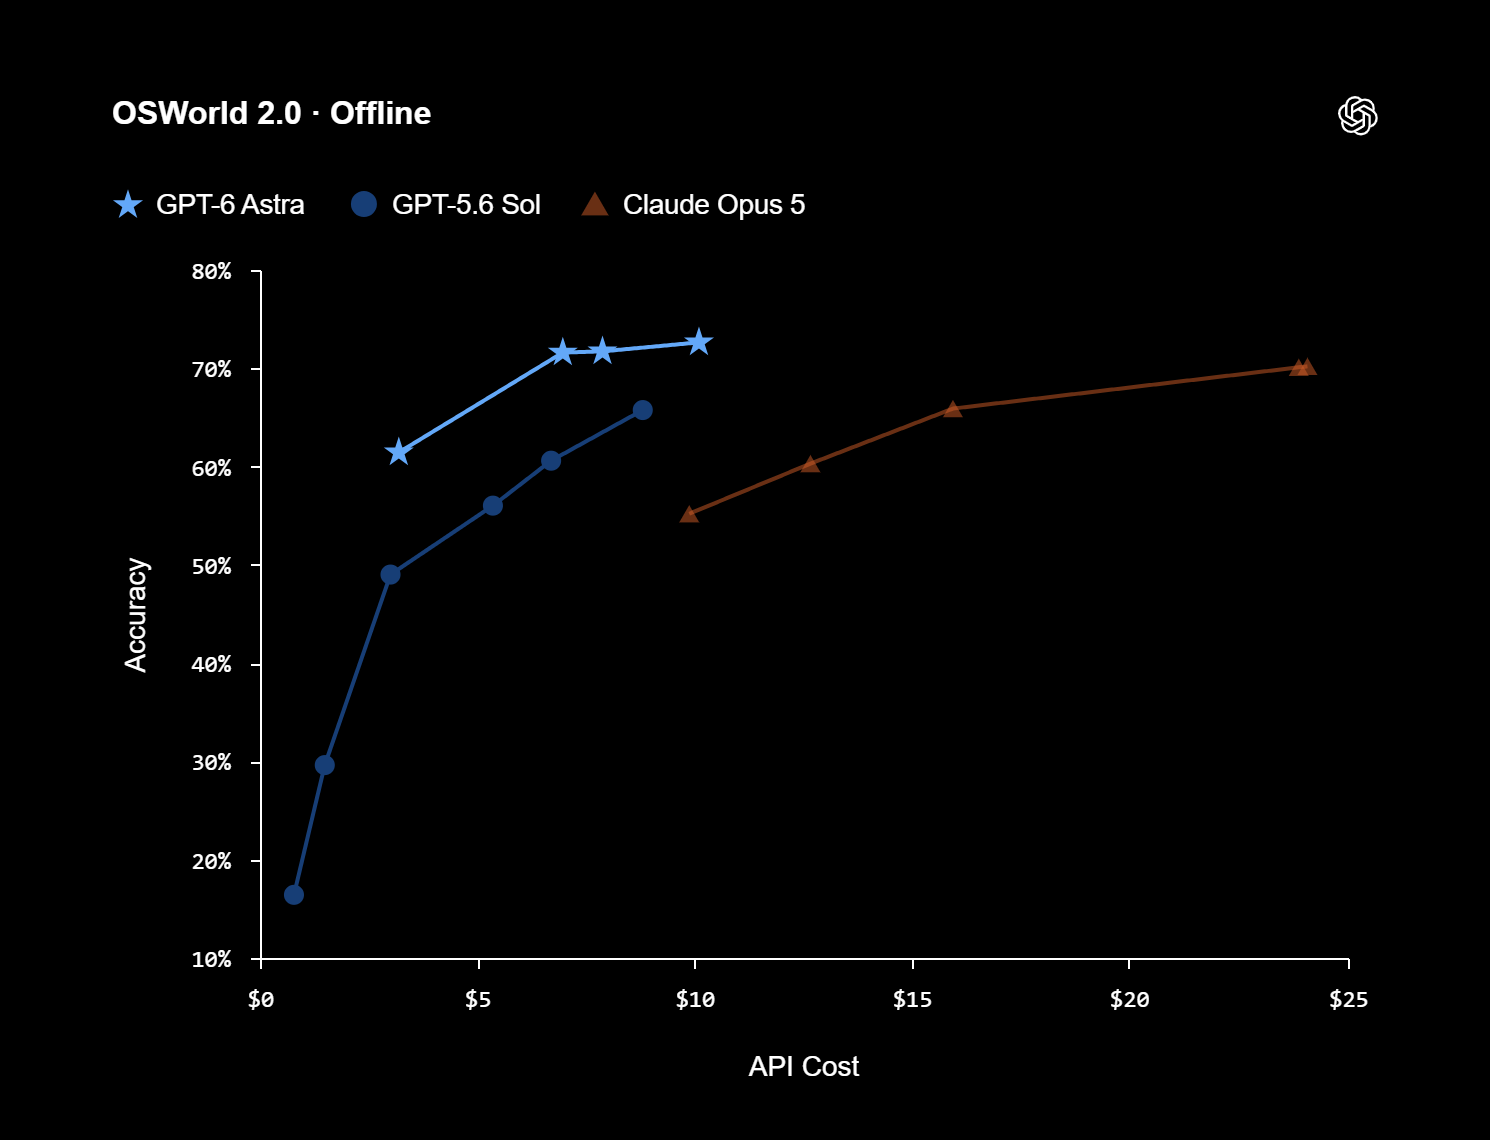
Într-o evaluare OSWorld 2.0, GPT-6 Astra a obținut un scor de 72,6%, comparativ cu 65,7% pentru GPT-5.6 Sol. OpenAI afirmă, de asemenea, că Astra poate realiza anumite sarcini de computer use în aproximativ 40 de minute, față de aproximativ 75 de minute pentru modelul anterior în simulările prezentate.

GPT-6 Astra OSWorld-2.0

GPT-6 Astra și programarea

Programarea este un alt domeniu în care GPT-6 Astra este poziționat ca model de top.

Modelul poate lucra pe proiecte software complexe, poate analiza cod, poate utiliza instrumente de dezvoltare și poate efectua verificări asupra aplicațiilor. OpenAI îl prezintă drept un model destinat nu doar generării de fragmente de cod, ci executării unor workflow-uri software end-to-end.

Această diferență este importantă pentru dezvoltatori. În loc să ceară AI-ului doar să scrie o funcție, utilizatorul poate delega o problemă mai amplă: analizarea unui proiect, implementarea unei modificări, testarea rezultatului și identificarea erorilor.

Performanțe ridicate în benchmark-uri

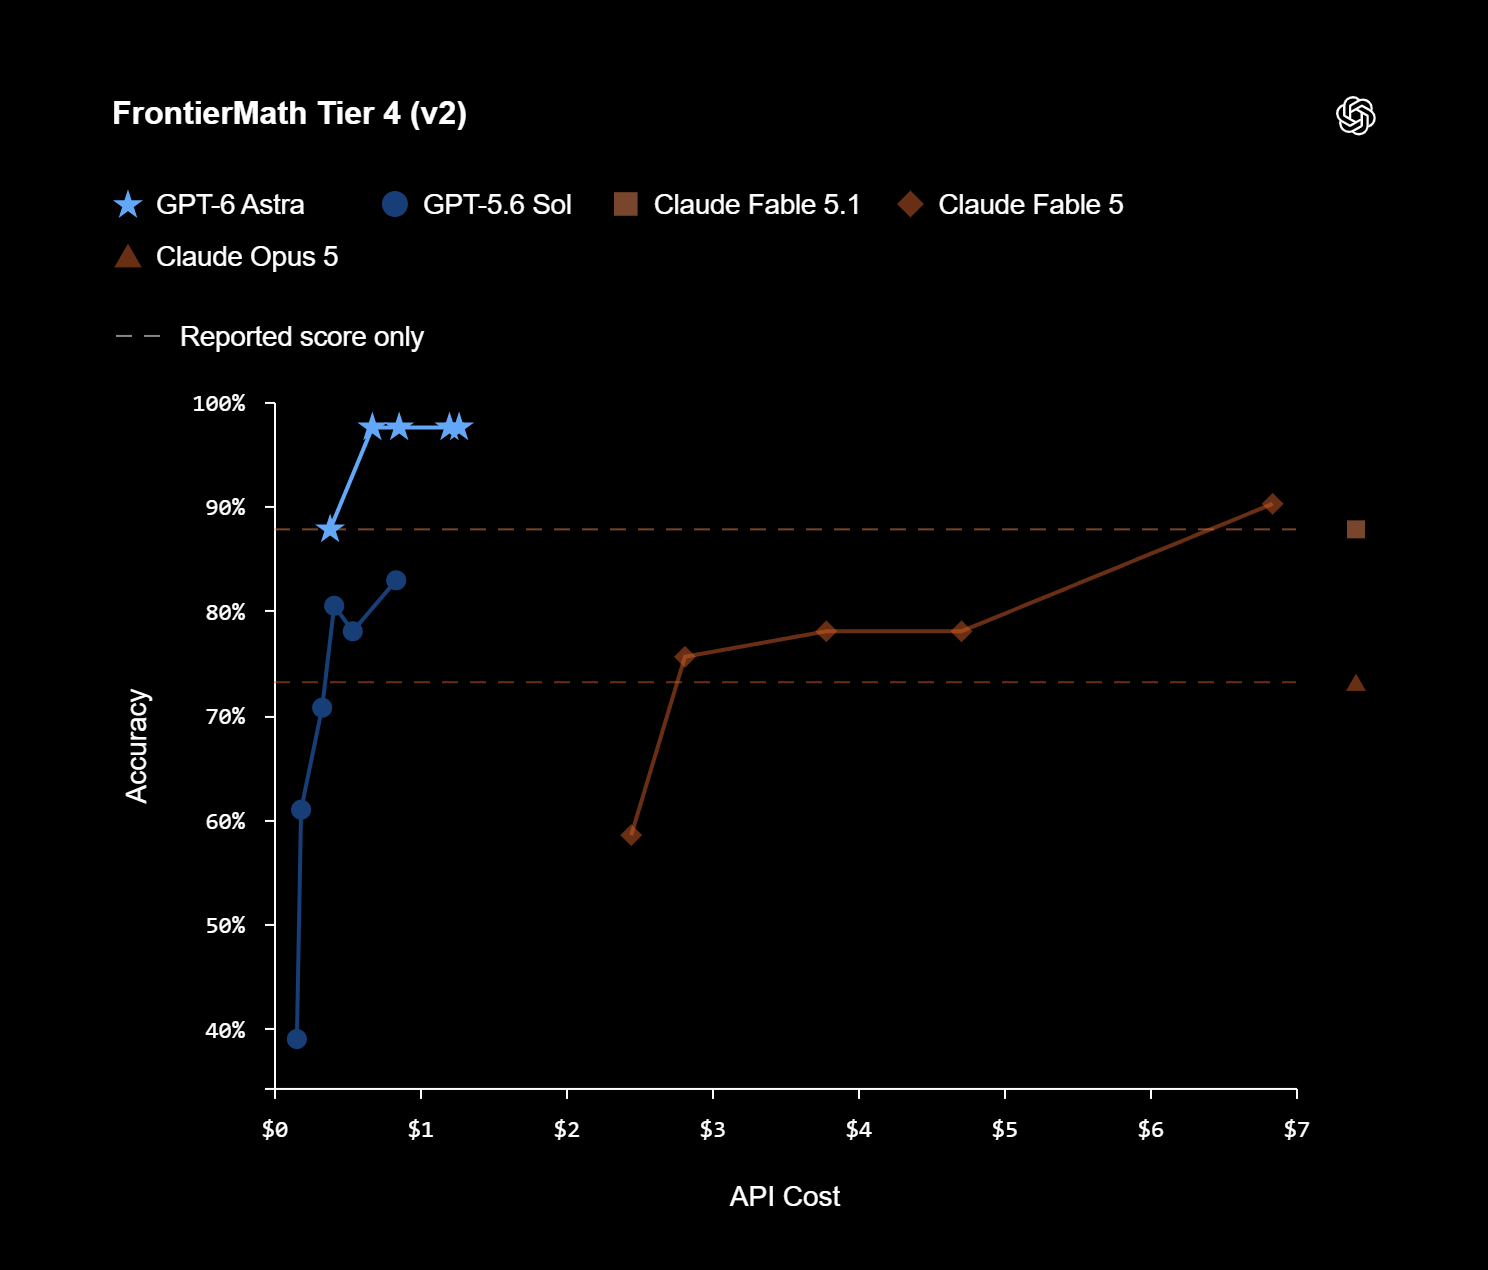
OpenAI susține că noul model stabilește rezultate de top în mai multe evaluări. Printre cifrele prezentate de companie se numără 99,9% pe ARC-AGI-3, 98% pe FrontierMath Tier 4 și 100% pe ExploitBench.

FrontierMath-Tier-4-v2

Este important însă ca aceste rezultate să fie interpretate în context: benchmark-urile sunt evaluări controlate, iar performanța într-un test nu garantează automat aceleași rezultate în orice situație reală.

GPT-6 Astra și securitatea cibernetică

Creșterea capacităților modelului vine și cu riscuri mai mari. OpenAI afirmă că este primul său model care atinge nivelul „Critical” pentru capacitățile de cybersecurity în cadrul Preparedness Framework. Compania spune că modelul poate identifica vulnerabilități de securitate necunoscute anterior și poate dezvolta metode de exploatare atunci când dispune de instrumentele și accesul necesare.

Din acest motiv, GPT-6 Astra include mecanisme suplimentare de monitorizare. OpenAI spune că anumite conversații sau activități pot fi întrerupte dacă sistemele detectează un posibil comportament problematic sau o interpretare greșită a instrucțiunilor.

Această componentă de siguranță devine tot mai importantă pe măsură ce modelele AI trec de la generarea de conținut la executarea unor acțiuni în lumea digitală.

Când este disponibil GPT-6 Astra?

Lansarea GPT-6 Astra se face gradual. OpenAI a început cu acces pentru un număr limitat de organizații, urmând ca modelul să fie disponibil mai larg pentru utilizatorii ChatGPT Plus, Pro, Business și Enterprise. Astra este disponibil și prin OpenAI API, Microsoft Azure și Amazon Bedrock.

Pentru dezvoltatori, modelul este identificat în API drept 

gpt-6-astra

. Documentația oficială indică o fereastră de context de până la 1.050.000 de tokeni și un maximum de 128.000 de tokeni pentru output. Prețul standard API este de 10 dolari pentru un milion de tokeni de input și 50 de dolari pentru un milion de tokeni de output.

Cât costă GPT-6 Astra?

Pentru API, prețul anunțat de OpenAI este:

  • Input: 10 USD / 1 milion de tokeni;
  • Cached input: 1 USD / 1 milion de tokeni;
  • Output: 50 USD / 1 milion de tokeni.

Există și un mod Fast, care poate oferi viteze de procesare mai mari, la un cost suplimentar.

Pentru utilizatorii ChatGPT, accesul este condiționat de nivelul abonamentului și de disponibilitatea progresivă a modelului.

Un pas către AGI?

Una dintre cele mai interesante întrebări este dacă modelul reprezintă un pas către Artificial General Intelligence (AGI).

OpenAI descrie Astra drept o nouă generație de inteligență și îl prezintă ca pe un model capabil să gestioneze o gamă foarte largă de activități intelectuale și profesionale. Totuși, termenul AGI nu are o definiție tehnică universal acceptată, iar performanțele ridicate ale unui model nu înseamnă automat că AGI a fost atins.

Ceea ce este mai ușor de observat este schimbarea de paradigmă: AI-ul devine tot mai capabil să execute sarcini, nu doar să ofere răspunsuri.

Ce înseamnă GPT-6 Astra pentru utilizatorii obișnuiți?

Pentru utilizatorul obișnuit, impactul GPT-6 Astra poate fi mai important în zona de automatizare decât în conversațiile clasice.

În viitorul apropiat, un utilizator ar putea solicita AI-ului să cerceteze un subiect, să compare informațiile, să organizeze rezultatele într-un document și să pregătească o prezentare. În mediul profesional, astfel de capabilități pot reduce timpul petrecut pentru activități repetitive și administrative.

Pentru companii, valoarea potențială este și mai mare: modelul poate fi integrat în fluxuri de lucru care implică documente, software, internet, date interne și aplicații de business.

Mai mult decât un simplu chatbot

GPT-6 Astra este mai mult decât o versiune nouă a unui chatbot. Direcția prezentată de OpenAI este aceea a unor sisteme AI capabile să raționeze, să utilizeze instrumente și să execute procese complexe de la început până la sfârșit.

Performanțele raportate în programare, folosirea computerului, cercetare, raționament și activități profesionale indică un progres semnificativ. În același timp, nivelul crescut de capabilități în securitatea cibernetică și nevoia de monitorizare suplimentară arată că progresul AI vine împreună cu provocări importante de siguranță.

Pentru utilizatori și companii, întrebarea nu mai este doar „Ce poate genera AI?” ci „Ce activități pot delega inteligenței artificiale în siguranță?„. GPT-6 Astra reprezintă una dintre cele mai clare încercări de până acum de a răspunde la această întrebare.

Sursa informațiilor: openai.com

PRODUSE RECOMANDATE

Poate AI-ul să gândească sau doar să prezică?

Timp de citit: 4 minutes

Când vorbești cu un chatbot AI și primești un răspuns coerent, argumentat și uneori chiar amuzant, este foarte ușor să ai impresia că în spatele ecranului există o „minte” care gândește.

Dar poate AI-ul să gândească în același sens în care gândește un om?

Răspunsul scurt este: nu știm să spunem că AI-ul gândește conștient precum un om. Modelele moderne procesează informații, identifică tipare și generează răspunsuri pe baza unor modele matematice extrem de complexe.

Și tocmai aici începe partea interesantă.


Ce face de fapt un model AI?

Un model de inteligență artificială este antrenat pe cantități uriașe de date.

În cazul modelelor de limbaj, acestea pot include texte, documentație, cod, conversații și multe alte tipuri de informații.

În timpul antrenării, modelul învață relațiile și tiparele statistice dintre elementele din aceste date.

Când îi adresezi o întrebare, modelul nu deschide o carte imaginară și nu caută răspunsul într-un sertar.

El procesează ceea ce i-ai oferit și generează un răspuns pe baza tiparelor pe care le-a învățat.


Predicția este cheia

Una dintre ideile fundamentale din spatele modelelor de limbaj este predicția.

Atunci când scrii o propoziție, modelul încearcă să determine ce element ar trebui să urmeze în contextul respectiv.

La prima vedere pare simplu.

Dar repetă acest proces de foarte multe ori, folosind modele matematice uriașe și cantități enorme de parametri, iar rezultatul poate deveni surprinzător de sofisticat.

De exemplu, dacă scrii:

„Capitala României este…”

modelul poate prezice foarte probabil:

„București”.

Dar lucrurile devin mult mai interesante atunci când îi ceri să explice un concept, să scrie cod sau să rezolve o problemă.


Atunci de ce pare că AI-ul gândește?

Pentru că rezultatele pot semăna foarte mult cu raționamentul uman.

Un model poate:

  • descompune o problemă;
  • compara variante;
  • explica o idee;
  • identifica greșeli;
  • scrie cod;
  • rezuma informații;
  • construi argumente;
  • urma instrucțiuni complexe.

Din exterior, toate acestea arată ca „gândire”.

Problema este că aspectul rezultatului nu ne spune automat ce se întâmplă în interior.

Un calculator poate calcula miliarde de operații fără să aibă experiența subiectivă a ceea ce face.


AI-ul înțelege ce spune?

Aici lucrurile devin mult mai complicate.

Dacă îi spui unui AI:

„Mi-e frică să vorbesc în public.”

poate genera un răspuns empatic și foarte bine formulat.

Dar faptul că poate descrie frica nu înseamnă că simte frică.

Este o diferență importantă între:

a putea reprezenta și procesa informații despre o experiență

și

a avea experiența respectivă.

Un AI poate vorbi despre emoții fără să existe dovezi că experimentează emoțiile respective.


Dar AI-ul poate rezolva probleme?

Da.

Și aici apare una dintre cele mai interesante evoluții ale inteligenței artificiale.

Modelele moderne pot aborda probleme în mai mulți pași și pot construi soluții din ce în ce mai complexe.

Pot, de exemplu:

  1. să analizeze problema;
  2. să identifice informațiile relevante;
  3. să construiască o strategie;
  4. să genereze o soluție;
  5. să verifice anumite rezultate;
  6. să corecteze greșeli.

Acest comportament poate semăna foarte mult cu raționamentul.

Totuși, capacitatea de a efectua raționamente nu demonstrează automat existența unei conștiințe.


Inteligența și conștiința sunt același lucru?

Nu.

Și aici este una dintre cele mai importante distincții.

Un sistem poate fi foarte performant într-o anumită sarcină fără să aibă conștiință.

De exemplu, un calculator poate calcula o formulă matematică mult mai repede decât un om.

Asta nu înseamnă că „înțelege” matematica în același mod în care o face un om.

Inteligența, raționamentul și conștiința sunt concepte diferite.


Ce este conștiința?

Conștiința este unul dintre cele mai dificile subiecte din filozofie și neuroștiință.

În termeni foarte simpli, se referă la experiența subiectivă de a exista și de a percepe lumea.

Tu nu doar procesezi informații despre o cafea.

O vezi.

O miroși.

O guști.

Ai o experiență personală asociată cu ea.

Pentru un AI, putem observa procesarea informației și rezultatul.

Dar nu avem o metodă sigură prin care să demonstrăm că un model are o experiență subiectivă similară.


AI-ul are propriile intenții?

În mod normal, nu.

Dacă îi ceri unui AI:

„Scrie-mi un plan pentru o vacanță.”

el nu se trezește dimineața și decide:

„Astăzi vreau să mă ocup de vacanța lui Guriță.” 😂

El răspunde la instrucțiunile primite.

Sistemele AI pot avea însă obiective, reguli, memorie sau acces la instrumente care le permit să execute mai mulți pași autonomi.

Aici intrăm în zona AI Agents.

Un agent poate primi un obiectiv și poate decide ce acțiuni sunt necesare pentru a-l îndeplini.

Dar autonomia operațională nu este același lucru cu dorința sau conștiința.


De ce poate AI-ul să greșească?

Dacă AI-ul „știe” atât de multe, de ce mai inventează uneori informații?

Pentru că un model AI nu este o enciclopedie perfectă.

El generează răspunsuri pe baza modelelor și informațiilor pe care le are disponibile.

În anumite situații poate produce un răspuns care sună foarte convingător, dar este greșit.

Aceste situații sunt cunoscute drept halucinații AI.

De aceea, pentru informații importante, rezultatele trebuie verificate.


Poate AI-ul să devină conștient?

Aici nu mai avem un răspuns definitiv.

Unii cercetători consideră că este posibil ca sistemele viitoare să dezvolte forme foarte avansate de procesare care să ridice din nou problema conștiinței.

Alții consideră că inteligența artificială poate deveni extrem de performantă fără să dezvolte vreodată o experiență subiectivă.

Problema este că nici măcar nu avem o definiție universal acceptată și completă a conștiinței.

Așa că întrebarea:

„Când devine un AI conștient?” sau ” poate AI-ul să gândească? “

este mult mai complicată decât pare.


Dacă AI-ul nu gândește ca noi, de ce este atât de puternic?

Pentru că nu trebuie să gândească exact ca un om pentru a fi util.

Un calculator nu trebuie să aibă emoții ca să proceseze milioane de operații.

Un AI nu trebuie să aibă conștiință ca să:

  • analizeze documente;
  • genereze cod;
  • traducă texte;
  • creeze imagini;
  • rezume informații;
  • automatizeze procese;
  • analizeze date;
  • asiste utilizatorii.

Adevărata putere a AI-ului vine tocmai din capacitatea sa de a procesa cantități uriașe de informații și de a produce rezultate într-un timp foarte scurt.


AI-ul va ajunge să gândească precum un om?

Poate.

Sau poate că nu.

Și acesta este unul dintre lucrurile care fac inteligența artificială atât de fascinantă.

Este posibil ca viitoarele sisteme să devină atât de sofisticate încât diferența dintre „calculează”, „raționează” și „gândește” să devină tot mai greu de definit.

Dar până când vom putea demonstra existența unei experiențe subiective, este mai corect să spunem că AI-ul procesează și generează informații extrem de sofisticat, nu că știm că are o minte conștientă.


Concluzie

Poate AI-ul să gândească?

Depinde foarte mult de ce înțelegem prin „a gândi”.

Dacă prin gândire înțelegem capacitatea de a analiza informații, de a identifica tipare și de a construi soluții, atunci sistemele AI pot face deja lucruri impresionante.

Dacă prin gândire înțelegem experiență conștientă, emoții, intenții și percepția propriei existențe, nu avem dovezi că modelele AI actuale funcționează astfel.

Iar poate cea mai interesantă întrebare nu este dacă AI-ul gândește.

Ci:

Dacă într-o zi va putea face tot ceea ce face un om atunci când gândește, vom mai putea spune că diferența contează? 🤖

WhatsApp testează funcția de securitate Scam Alert

Timp de citit: 5 minutes

Meta lansează în versiune beta o nouă funcție WhatsApp, numită Scam Alert, care folosește inteligența artificială direct pe telefon pentru a identifica mesaje ce ar putea face parte dintr-o tentativă de fraudă. Tehnologia este concepută astfel încât conținutul mesajelor să nu părăsească dispozitivul pentru procesare.

Escrocheriile online au devenit tot mai sofisticate. De la mesaje care imită instituții sau companii cunoscute până la tehnici de inginerie socială și tentative de manipulare generate cu ajutorul inteligenței artificiale, atacatorii încearcă să convingă utilizatorii să divulge informații, să acceseze linkuri sau să efectueze plăți.

În acest context, WhatsApp testează Scam Alert, o funcție opțională de securitate bazată pe un model de machine learning care rulează local, pe dispozitivul utilizatorului. Potrivit documentației tehnice publicate de Meta pe 12 august 2026, obiectivul este să ofere un avertisment înainte ca utilizatorul să interacționeze cu un posibil scam, păstrând în același timp principiile criptării end-to-end.

Ce este WhatsApp Scam Alert și cum funcționează?

Scam Alert este, în această etapă, o funcție opțională, disponibilă într-o versiune beta limitată. După activare, WhatsApp descarcă pe telefon un model de machine learning care analizează anumite mesaje primite de la persoane care nu se află în lista de contacte.

Modelul nu caută pur și simplu anumite cuvinte-cheie. Meta spune că acesta utilizează semnale lingvistice și structura conversației, realizând o clasificare probabilistică bazată pe tipare observate în conversații asociate cu fraude. Datele de antrenare provin din conversații scam raportate anterior de utilizatori.

Dacă sistemul estimează că există o probabilitate ridicată ca mesajele să facă parte dintr-o tentativă de fraudă, utilizatorul poate primi un avertisment în conversație. Acesta îi oferă opțiuni precum blocarea și raportarea expeditorului sau continuarea conversației.

Important este că avertismentul nu reprezintă o dovadă absolută că mesajul este fraudulos. Este o măsură de asistență și prevenție, iar utilizatorul păstrează controlul asupra deciziei.

Mesajele nu sunt trimise către Meta pentru analiză

Una dintre cele mai importante caracteristici ale Scam Alert este faptul că analiza are loc direct pe telefon.

Conform Meta, atât modelul de machine learning, cât și datele mesajelor procesate pentru clasificare rămân pe dispozitiv. Conținutul mesajelor nu este transmis automat către WhatsApp, Meta sau către o altă terță parte pentru identificarea fraudelor.

Acest aspect este important deoarece WhatsApp utilizează criptare end-to-end pentru conversațiile personale. O soluție tradițională de detectare a fraudelor ar putea presupune transmiterea mesajelor către servere pentru analiză. Scam Alert încearcă să evite această abordare prin mutarea procesării pe dispozitiv.

Meta definește explicit trei principii pentru această funcție:

  • procesare exclusiv pe dispozitiv;
  • fără raportare automată;
  • control din partea utilizatorului.

Funcția poate fi activată sau dezactivată de utilizator, iar simpla detectare a unui posibil scam nu determină transmiterea automată a conversației către companie.

Ce se întâmplă dacă Scam Alert greșește?

Ca orice sistem de clasificare bazat pe machine learning, Scam Alert poate produce și rezultate false. Un mesaj legitim poate semăna cu un tipar întâlnit în conversațiile frauduloase.

WhatsApp introduce de aceea un mecanism prin care utilizatorul poate marca o conversație ca fiind de încredere, dacă avertismentul este considerat incorect. În acest caz, avertismentul este eliminat, iar Scam Alert nu ar trebui să mai semnaleze respectiva conversație în același mod.

Există și o opțiune suplimentară: dacă utilizatorul alege să aibă încredere în conversație, poate opta pentru transmiterea către WhatsApp a ultimelor cinci mesaje primite, pentru îmbunătățirea acurateței sistemului. Această transmitere este legată de acțiunea explicită a utilizatorului și nu reprezintă raportare automată.

Cum sunt folosite datele fără a expune conversațiile criptate?

Aici se află una dintre componentele tehnice interesante ale proiectului. Meta spune că are nevoie să măsoare dacă Scam Alert funcționează corect: cât de des apare un avertisment și ce fac utilizatorii după apariția acestuia.

Pentru a îmbunătăți Scam Alert fără să colecteze conținutul conversațiilor, Meta folosește două tehnologii de protecție a datelor. Prima (Confidential Federated Analytics) permite analizarea statisticilor în mod distribuit și securizat, fără ca mesajele individuale să fie trimise companiei. A doua (Differential Privacy) adaugă un nivel suplimentar de protecție a datelor, astfel încât rezultatele statistice să nu poată fi folosite pentru a identifica un anumit utilizator sau conversația acestuia.

În practică, sistemul urmărește doar indicatori agregați, precum:

  • numărul aproximativ de avertismente generate;
  • categoriile de acțiuni întreprinse de utilizatori după avertisment.

Aceste date sunt agregate, iar mecanismele de confidențialitate sunt concepute astfel încât informațiile despre o persoană individuală să nu poată fi deduse din statisticile transmise. Meta afirmă că agregatele disponibile companiei nu conțin informații despre un utilizator individual.

Pentru procesarea acestor statistici, Meta utilizează și medii de execuție securizate (Trusted Execution Environments – TEE) și mașini virtuale confidențiale. Arhitectura include, printre altele, verificarea codului executat și mecanisme prin care cercetătorii pot verifica independent anumite componente ale sistemului.

Sistemul împiedică direcționarea modelului AI către persoane specifice

Unul dintre riscurile interesante ale sistemelor AI distribuite este posibilitatea ca un server să livreze unui anumit utilizator o versiune diferită a modelului.

Meta susține că a proiectat Scam Alert astfel încât un model specific să nu poată fi livrat în mod deliberat unui utilizator prestabilit.

Versiunile modelului sunt înregistrate într-un registru public de transparență, iar fiecare versiune este asociată cu hash-uri criptografice. Registrul este de tip append-only, ceea ce înseamnă că intrările pot fi adăugate, dar nu modificate sau șterse ulterior.

În plus, solicitările pentru descărcarea modelului folosesc credentiale anonime și sunt transmise printr-un mecanism OHTTP care elimină IP-ul utilizatorului din cererea văzută de serverul care livrează modelul.

Un alt element important este că atribuirea utilizatorului către variante experimentale ale modelului se face local, pe dispozitiv, folosind aleatoriu, nu printr-o decizie luată de server pentru o persoană identificată.

Utilizatorii și cercetătorii pot verifica ce model rulează

Scam Alert introduce și o componentă de verificabilitate.

Meta intenționează să publice informațiile necesare pentru verificarea integrității modelelor AI. Pe dispozitiv, utilizatorii pot activa jurnale de transparență care arată ce mesaje au fost analizate, rezultatul analizei și versiunea modelului utilizat.

În WhatsApp, informațiile pot fi accesate din Account > Request Info > Scam Alert Activity, potrivit documentației tehnice publicate de Meta.

În paralel, cercetătorii de securitate sunt implicați prin programul Bug Bounty. Meta afirmă că le oferă acces la componentele relevante pentru a verifica dacă mesajele rămân pe dispozitiv și dacă modelul are într-adevăr scopul declarat de detectare a scam-urilor.

Când va fi disponibil Scam Alert pentru toți utilizatorii WhatsApp?

În acest moment nu există încă o dată de lansare oficială.

Meta descrie Scam Alert drept o funcție aflată într-o versiune beta limitată și precizează că sistemul va fi testat și îmbunătățit înainte de disponibilitatea la scară largă. Compania lucrează inclusiv cu cercetători din comunitatea Bug Bounty pentru a identifica probleme de securitate, confidențialitate și comportament al modelului.

Prin urmare, utilizatorii WhatsApp nu ar trebui să presupună că funcția este deja disponibilă pe toate telefoanele sau în toate regiunile.

De ce este importantă această abordare?

Scam Alert arată o direcție interesantă pentru securitatea aplicațiilor de mesagerie: folosirea AI pentru protecție fără transformarea conversațiilor private într-o sursă centralizată de date pentru analiză.

Potrivit BleepingComputer, WhatsApp are peste 3 miliarde de utilizatori în peste 180 de țări, ceea ce face ca orice mecanism de prevenire a fraudelor implementat la nivelul platformei să poată avea un impact semnificativ.

În același timp, utilizatorii trebuie să înțeleagă că Scam Alert nu înlocuiește atenția personală. Un model AI poate identifica tipare și poate avertiza asupra unor conversații suspecte, dar nu poate garanta că fiecare mesaj fraudulos va fi detectat.

Regula de bază rămâne aceeași: nu transmite coduri de autentificare, parole, date bancare sau alte informații sensibile doar pentru că un expeditor pretinde că reprezintă o bancă, o companie, un prieten sau o instituție.

Concluzie

WhatsApp Scam Alert este o încercare de a combina detectarea automată a fraudelor cu protejarea confidențialității. Modelul de machine learning rulează local, mesajele nu sunt trimise automat către Meta pentru clasificare, iar utilizatorul decide dacă un avertisment este corect și dacă dorește să raporteze conversația.

Mai mult, Meta introduce mecanisme de transparență, registre publice pentru versiunile modelelor, verificare criptografică și testare prin cercetători externi.

Pentru utilizatorul obișnuit, beneficiul este simplu: dacă funcția ajunge la o lansare completă și modelul se dovedește suficient de precis, WhatsApp ar putea oferi un strat suplimentar de protecție împotriva mesajelor scam, fără ca analiza conversațiilor să necesite renunțarea la criptarea end-to-end.

Totuși, pentru moment, Scam Alert trebuie privit ca un sistem aflat în testare, nu ca o garanție împotriva fraudelor. Cea mai eficientă apărare rămâne combinația dintre tehnologia de securitate, actualizarea aplicației și capacitatea utilizatorului de a recunoaște semnalele unei tentative de fraudă.

Sursa: engineering.fb.com